Lernziele
Nach diesem Kapitel kannst du:
- erklären, woraus der Kontext eines Agentenaufrufs besteht — Systemanweisung, Projektdateien, Ziel, Werkzeugergebnisse.
- Werkzeuge und Permissions unterscheiden und begründen, warum ein Agent nie „alles darf“.
- den headless-Betrieb verstehen: was
--printbedeutet und warum ein Agent ohne Mensch am Terminal anders konfiguriert werden muss. - Sitzungen und Modelle einordnen: was zwischen zwei Aufrufen erhalten bleibt und nach welchen Kriterien man ein Modell wählt.
- die Execution-Adapter der Fabrik benennen und einen Run unter
/runs/newmit Adapter, Team und Ziel anlegen. - den Run-Lebenszyklus lesen: sieben Phasen, die technischen Status und den Unterschied zwischen PLAN- und BUILD-Run.
- Abo- und API-Key-Modus unterscheiden und wissen, wie die Fabrik Kosten im Abo-Modus ausweist.
2.1 Anatomie eines Agentenaufrufs
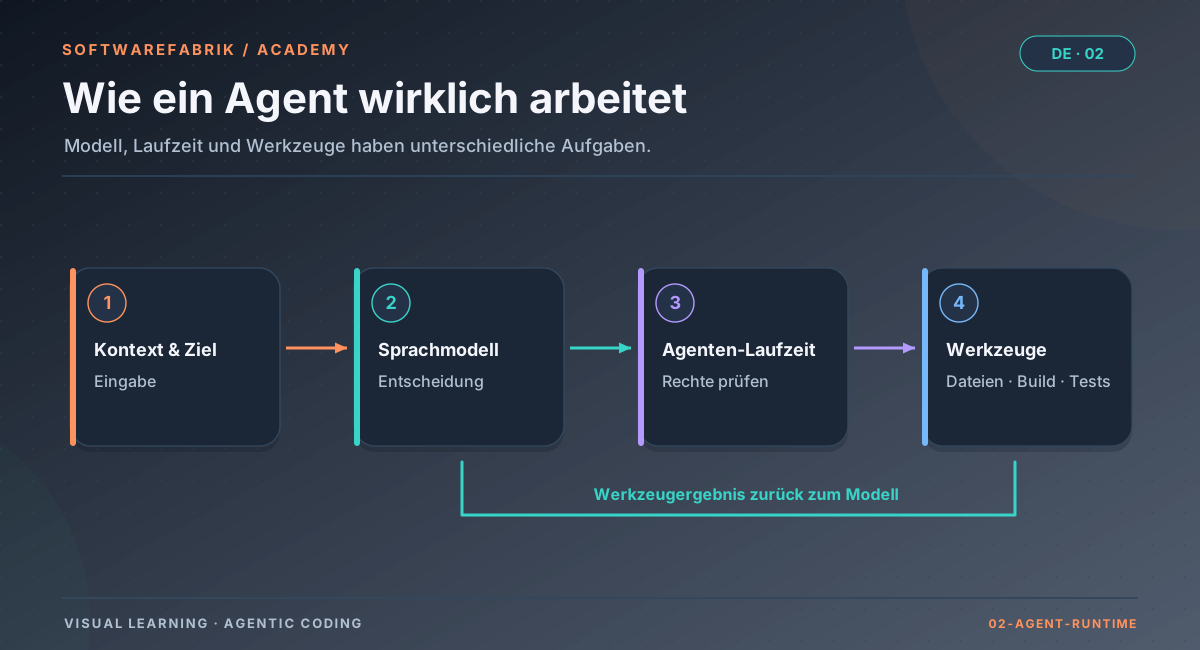
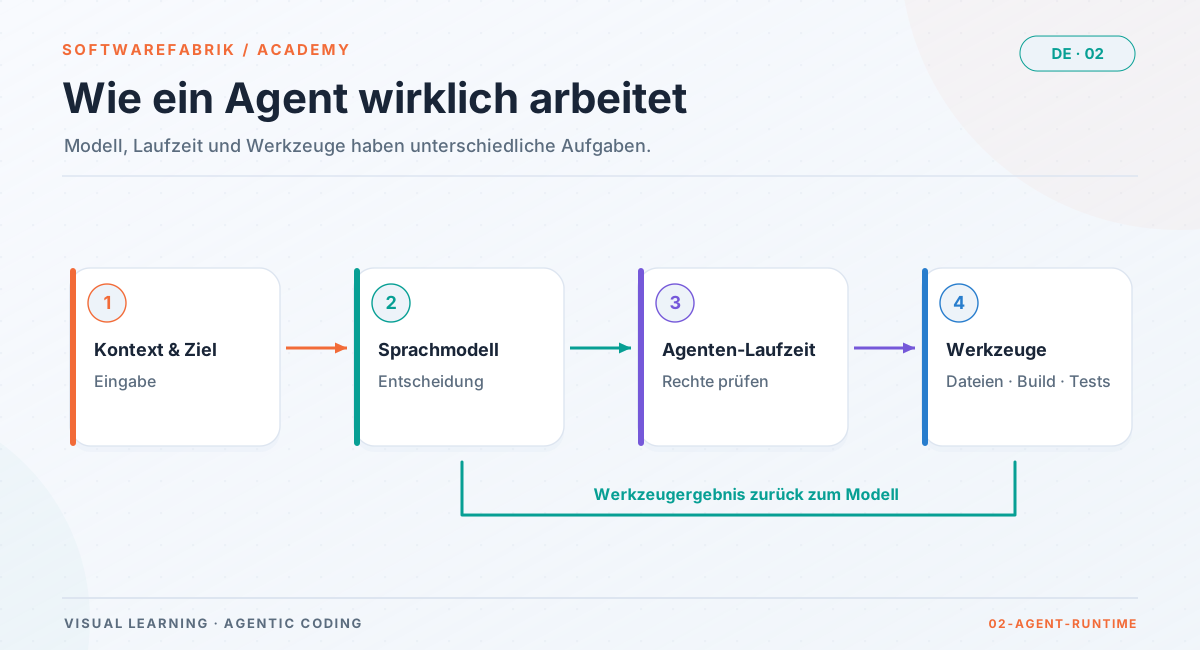
Moderne Coding-Agenten wie Claude Code, OpenAI Codex, Gemini CLI, Aider oder die Kimi-CLI sind Kommandozeilenprogramme. Sie verbinden ein Sprachmodell (meist über das Netz beim Anbieter, manchmal lokal) mit Werkzeugen auf deinem Rechner. Wenn du einen solchen Agenten startest, passiert grob Folgendes:
- Das Programm stellt einen Startkontext zusammen: eine eingebaute Systemanweisung des Herstellers („Du bist ein Coding-Assistent, du hast diese Werkzeuge…“), gegebenenfalls Konfigurationsdateien aus deinem Home-Verzeichnis und aus dem Projekt, und deine Aufgabe.
- Es schickt den Kontext an das Modell und bekommt entweder Text oder einen Werkzeugaufruf zurück.
- Es prüft, ob der Werkzeugaufruf erlaubt ist (Permissions), führt ihn aus und hängt das Ergebnis an den Kontext an.
- Es wiederholt die Schritte 2 und 3, bis das Modell die Aufgabe für erledigt hält, ein Limit greift oder ein Fehler auftritt.
- Es gibt eine Abschlussmeldung aus — je nach Modus als Text oder als strukturiertes JSON mit Ergebnis, Token-Verbrauch und gegebenenfalls einer Kostenschätzung.
Der Prompt ist mehr als deine Aufgabe
Wenn man von „dem Prompt“ spricht, meint man oft nur den Satz, den man eintippt. Tatsächlich besteht der Kontext eines Agenten aus mehreren Schichten:
| Schicht | Herkunft | Beispiel |
|---|---|---|
| System-Prompt | Hersteller des Agenten | Beschreibung der Werkzeuge, Verhaltensregeln |
| Konfiguration und Gedächtnisdateien | Home-Verzeichnis, Projekt (etwa AGENTS.md, CLAUDE.md) | Konventionen, Build-Befehle, Verbote |
| Aufgabe | du bzw. das aufrufende System | „Implementiere den Endpunkt …“ |
| Arbeitsverlauf | die Schleife selbst | gelesene Dateien, Build-Ausgaben, eigene Zwischenschritte |
Die zweite Schicht ist tückisch: Viele Agenten laden Konfiguration automatisch — aus deinem Home-Verzeichnis (persönliche Einstellungen, Plugins, angebundene Dienste) und aus dem Projektverzeichnis. Was praktisch ist, wenn du allein an deinem eigenen Code arbeitest, wird zum Problem, wenn ein Agent in einem fremden Repository oder auf einem gemeinsam genutzten Rechner läuft: Dann bestimmt jemand anderes mit, was der Agent weiß und darf. Wie die Fabrik damit umgeht, siehst du unten im Praxis-Kasten „Ephemeres HOME“ und ausführlich in Kapitel 8.
2.2 Werkzeuge und Permissions
In Kapitel 1 hast du gelernt: Ein Agent kann alles, was seine Werkzeuge können. Permissions (Berechtigungen) sind die Schicht, die festlegt, welche Werkzeugaufrufe tatsächlich ausgeführt werden. Sie sind die wichtigste Stellschraube zwischen Nützlichkeit und Risiko.
Typische Permission-Modelle
- Fragen bei jeder Aktion: Der Agent zeigt jeden Schreib- oder Ausführungsschritt an und wartet auf deine Bestätigung. Sicher, aber im Alltag mühsam — und ohne Mensch am Terminal unbrauchbar.
- Erlaubnislisten (Allowlists): Bestimmte Werkzeuge oder Befehlsmuster sind vorab erlaubt, etwa „Dateien bearbeiten“ oder „
mvnmit beliebigen Argumenten“. Alles andere wird abgelehnt oder erfordert Rückfrage. - Verbotslisten (Denylists): Bestimmte Werkzeuge sind ausdrücklich gesperrt, etwa Schreiben für einen reinen Prüfagenten.
- Alles erlauben: Viele Agenten haben einen Modus, der sämtliche Prüfungen abschaltet. Er ist für Wegwerf-Umgebungen gedacht (eine virtuelle Maschine, die danach gelöscht wird) — nicht für einen Rechner mit Zugangsdaten, SSH-Schlüsseln und Firmennetz.
Das Prinzip der geringsten Rechte
Ein Agent sollte genau die Rechte bekommen, die seine Aufgabe erfordert, und nicht mehr. Für einen Agenten, der Code schreibt und testet, heißt das etwa: Dateien im Projekt lesen und schreiben, Build- und Testwerkzeuge ausführen, lesende Git-Befehle. Nicht nötig sind dagegen: beliebige Netzwerkzugriffe (curl, wget), Löschen außerhalb des Projekts, git push. Commit und Push übernimmt besser das umgebende System — dann sind sie kontrolliert und nachvollziehbar.
Ein Prüfagent (Reviewer) braucht noch weniger: Er soll lesen und urteilen, aber nichts verändern. Genau hier ist eine harte technische Sperre wertvoller als eine freundliche Bitte im Prompt: „Bitte ändere nichts“ ist eine Anweisung, die ein Modell missverstehen kann; ein gesperrtes Schreibwerkzeug ist eine Tatsache.
In der Fabrik
Der Permission-Vertrag für Claude Code
Für den Claude-Code-Adapter legt die Fabrik die Rechte ausdrücklich fest — nicht über die Oberfläche, sondern nur über YAML bzw. Umgebungsvariablen, also als bewusste Betriebsentscheidung:
- Build- und Plan-Runs starten die CLI mit
--permission-mode acceptEditsund einer--allowedTools-Liste. Ohne das Flag würde Claude Code im headless-Betrieb keine Dateien schreiben, sondern im Text um Erlaubnis bitten. - Sicherer Default der Allowlist (wenn nichts konfiguriert ist): Lesen, Suchen, Build- und Testwerkzeuge, lesendes Git,
ls— keingit commit/push, keincurl/wget, keinrm. - Konfiguration:
SOFTWAREFABRIK_CLAUDECODE_PERMISSION_MODE(DefaultacceptEdits) undSOFTWAREFABRIK_CLAUDECODE_ALLOWED_TOOLS(Komma-Liste in Permission-Regel-Syntax, z. B.Bash(mvn *)). - Abgelehnt:
bypassPermissionsbzw.--dangerously-skip-permissionsverweigert die Fabrik beim Start — die CLI läuft auf dem Host, nicht in einer Wegwerf-VM. - Reviews laufen mit
--permission-mode dontAskund--disallowedToolsfür Edit, Write und Bash. Sie sind damit technisch read-only.
SOFTWAREFABRIK_CLAUDECODE_ALLOWED_TOOLS=Read,Glob,Grep,Bash(mvn *),Bash(git status),Bash(git diff *)Bash(npx *) und Bash(node *) — beide führen beliebigen Code aus. Wer das nicht will, setzt die Allowlist explizit, wie im Beispiel oben. Die Flags sind CLI-versionsabhängig; der Isolationsnachweis (Canary, Kapitel 8) prüft den produktiven Aufruf inklusive dieser Flags.
2.3 Headless: Agenten ohne Mensch am Terminal
Im Alltag nutzen viele Entwickler:innen Agenten interaktiv: Man öffnet eine Sitzung im Terminal, gibt eine Aufgabe ein, beobachtet, beantwortet Rückfragen, bestätigt Aktionen. Für automatisierte Abläufe — CI-Pipelines, Skripte, eine Control Plane wie die Fabrik — braucht man den headless-Betrieb: Der Agent bekommt seine Aufgabe als Argument, arbeitet sie ab und beendet sich mit einem Ergebnis.
Bei Claude Code heißt der Schalter dafür --print (kurz -p); andere CLIs haben Entsprechungen wie codex exec, gemini -p oder bei Aider --message zusammen mit --yes. Gemeinsam ist allen:
- Keine Rückfragen möglich. Niemand antwortet. Der Agent muss mit Unklarheiten selbst umgehen — gute Anweisungen sagen ihm, wie (Annahmen festhalten, die konservativste Auslegung wählen, Abweichungen deutlich markieren).
- Permissions müssen vorab feststehen. Ein Agent, der auf eine Bestätigung wartet, die nie kommt, tut entweder nichts oder bittet in seiner Textausgabe um Erlaubnis.
- Strukturierte Ausgabe. Mit einem Ausgabeformat wie JSON lässt sich das Ergebnis maschinell auswerten: Erfolg oder Fehler, Token-Verbrauch, gegebenenfalls die Kostenschätzung der CLI.
- Zeitlimits. Ein headless-Lauf braucht eine Obergrenze, damit ein hängender Agent nicht ewig läuft.
claude --print --output-format json \
       --permission-mode acceptEdits \
       --allowedTools "Read,Glob,Grep,Bash(mvn *)" \
"Lies PROJECT.md und INSTRUCTIONS.md und beginne mit der Umsetzung. ..."2.4 Sitzungen und Gedächtnis
Eine Sitzung ist der zusammenhängende Arbeitsverlauf eines Agenten — alles, was in einem Kontextfenster zusammengehört. Viele Agenten können Sitzungen speichern und später fortsetzen. Für reproduzierbare, nachvollziehbare Arbeit ist das aber nur bedingt hilfreich: Der Inhalt einer Sitzung ist schwer einsehbar, hängt an einem Rechner und einem Werkzeug und wächst mit jedem Schritt.
Robuster ist es, dauerhaftes Wissen in Dateien zu halten, die im Repository liegen und bei jedem Lauf neu gelesen werden:
- Projektbeschreibung — was gebaut wird und warum.
- Arbeitsanweisungen — Konventionen, Build-Befehle, Verbote.
- Gedächtnis — Entscheidungen und Erkenntnisse aus früheren Läufen.
- Der Code selbst und seine Git-Historie — die zuverlässigste Quelle dafür, was bisher passiert ist.
So startet jeder Lauf mit einem frischen, definierten Kontext, und das „Gedächtnis“ ist für Menschen lesbar, versioniert und reviewbar. Diese Strategie verfolgt auch die Fabrik: Jeder Run ist ein neuer headless-Aufruf; was zwischen Runs erhalten bleiben soll, steht im Workspace (Artefakte, MEMORY.md, Code). Details dazu in Kapitel 3.
2.5 Modelle: welches Gehirn für welche Aufgabe?
Hinter jedem Agenten steht ein Modell, und die meisten Agenten lassen dich zwischen mehreren Modellen wählen. Ohne konkrete Produktnamen — die sich ständig ändern — lassen sich einige dauerhafte Kriterien nennen:
- Fähigkeit: Größere Modelle sind meist besser bei Planung, Architekturfragen und schwierigen Fehlern.
- Kosten: Sie sind auch teurer pro Token und oft langsamer.
- Geschwindigkeit: Kleinere Modelle eignen sich für mechanische Arbeit und schnelle Prüfungen.
- Kontextfenster: Wie viel passt in einen Aufruf?
- Datenhaltung und Ort: Wo läuft das Modell? Darf der Code die Firma verlassen? Für manche Umgebungen kommt nur ein lokal betriebenes Modell in Frage.
Eine bewährte Faustregel lautet: stark planen, günstig umsetzen, schnell prüfen. Die Planung eines Vorhabens ist selten, aber folgenreich — hier lohnt ein starkes Modell. Die mechanische Umsetzung eines klaren Plans gelingt auch mit einem mittleren Modell. Für Reviews mit klarer Fragestellung reicht oft ein kleines, schnelles Modell. Wie die Fabrik diese Rangfolge abbildet (Routing, Team-Präferenz, Rollen-Default), behandelt Kapitel 10.
In der Fabrik
Execution-Adapter: ein Agent, viele Hersteller
Die Fabrik bindet Coding-Agenten nicht fest ein, sondern über Execution-Adapter. Ein Adapter weiß, wie man eine bestimmte CLI headless aufruft, wie man ihr die Aufgabe übergibt, welche Zugangsdaten sie braucht und wie man ihre Ausgabe auswertet. Die Fabrik ruft die CLI als Subprozess auf.
| Adapter | Agent / Backend | Zugang |
|---|---|---|
claude | Claude Code | Claude-Abo oder ANTHROPIC_API_KEY |
codex | OpenAI Codex | ChatGPT-Abo oder OPENAI_API_KEY |
gemini | Google Gemini CLI | GEMINI_API_KEY |
aider | Aider | je nach Backend-Modell |
kimi | Kimi-CLI (Moonshot AI) | Kimi-Abo oder KIMI_API_KEY/MOONSHOT_API_KEY |
local-llm | OpenAI-kompatibles lokales Backend (Ollama, vLLM, LM Studio) | kein Cloud-Zugang nötig (Air-Gap) |
bedrock, vertex, azure-openai | Cloud-Gateways | Cloud-Zugangsdaten — experimentell, nicht end-to-end verifiziert |
mock | kein echter Agent | — zum kostenlosen Üben |
Der Standard-Adapter wird global über SOFTWAREFABRIK_EXECUTION_ADAPTER bzw. in den Einstellungen über execution.adapter.default gesetzt. Projekt- und Mandanten-Policies können die erlaubten Adapter einschränken — etwa auf lokale Backends für besonders schutzbedürftige Projekte.
Allen Adaptern gemeinsam ist der Kern der Aufgabe: Die Fabrik übergibt dem Agenten den Auftrag, PROJECT.md und INSTRUCTIONS.md zu lesen, sich strikt an die Vorgaben zu halten, und hängt das Ziel des Runs an. Vor das Ziel setzt sie die vendor-neutralen Engineering-Guardrails (Kapitel 3) — so bekommt jeder Agent, egal von welchem Hersteller, dieselben Leitplanken.
In der Fabrik
Einen Run anlegen: /runs/new
Ein Run ist ein überwachter Ausführungslauf des Agenten gegen ein Ziel. Beim Anlegen unter /runs/new wählst du drei Dinge:
- Adapter — welcher Agent ausführt. Default aus den Einstellungen, gegebenenfalls eingeschränkt durch Projekt- oder Mandanten-Policy.
- Team — die beteiligten Agentenrollen (gepflegt unter
/teams). Das Team bestimmt unter anderem ein Wunschmodell (preferredModel). - Ziel (objective) — frei pro Run, bis zu 4000 Zeichen. Genau hier sagst du, was dieser Run tun soll.
Ziel: Lege das Spring-Boot-Skelett gemäß PROJECT.md an, implementiere den
Auftrags-CRUD (Entity, Repository, REST unter /api/v1) und ein React-Frontend
mit Auftragsliste. mvn verify muss grün sein.Ein gutes Ziel ist konkret, verweist auf die Projektartefakte statt sie zu wiederholen und nennt ein prüfbares Erfolgskriterium („mvn verify muss grün sein“). Wie man Ziele noch präziser fasst — mit Akzeptanzkriterien und IDs — zeigt Kapitel 4.
Im SDLC-Alltag legst du viele Build-Runs gar nicht von Hand an: Ein Backlog-Eintrag wird „aktiviert“ und startet einen Build-Run, dessen Ziel der zugehörige Plan ist (Kapitel 5).
2.6 Warum ein Agentenlauf einen Lebenszyklus braucht
Ruft man einen Agenten einfach im Terminal auf, gibt es genau zwei Zustände: läuft oder fertig. Für kontrollierte Softwareentwicklung reicht das nicht. Man möchte wissen: Ist die Arbeitsumgebung vorbereitet? Wartet der Lauf auf eine Freigabe? Läuft gerade die Prüfung? Ist er gescheitert, abgebrochen, in einer Zeitüberschreitung hängen geblieben? Und man möchte an bestimmten Punkten eingreifen können: pausieren, abbrechen, freigeben.
Ein expliziter Lebenszyklus mit Phasen und Status macht einen Agentenlauf zu einem steuerbaren Prozess. Jede Phase hat eine klare Aufgabe; jeder Statuswechsel ist ein Ereignis, das man protokollieren, auswerten und absichern kann. Das ist die Voraussetzung für alles, was in späteren Kapiteln folgt: Freigaben, Quality Gates, Korrekturschleifen, Nachweise.
In der Fabrik
Der Run-Lebenszyklus: sieben Phasen, klare Status
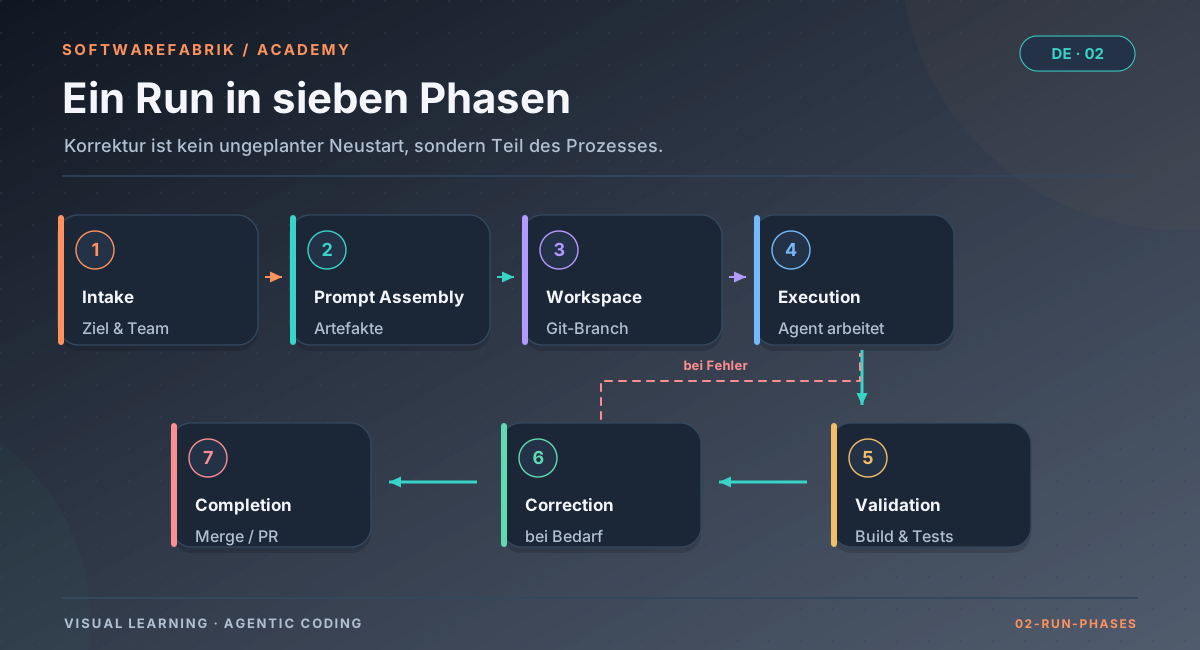
Ein Run durchläuft sieben fachliche Phasen:
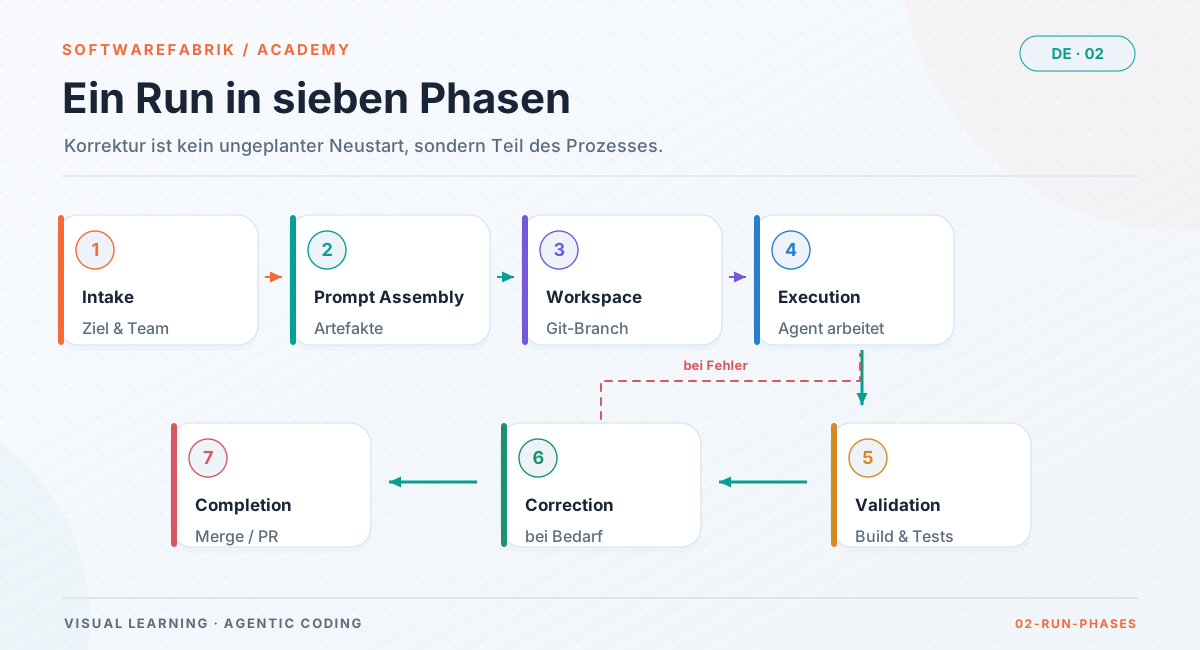
Grafik in voller Größe öffnenGrafik in voller Größe öffnen
| Phase | Was passiert |
|---|---|
INTAKE | Projekt und Team werden ausgewählt; dazu kommen Adapter und Ziel des Runs. |
PROMPT_ASSEMBLY | Die Markdown-Artefakte werden erzeugt und bei Bedarf bearbeitet; sie bilden zusammen mit dem Ziel die Eingabe des Agenten. |
WORKSPACE_PREPARATION | Der Workspace wird vorbereitet (beim ersten Run git init), die Markdown-Artefakte werden geschrieben und als Checkpoint committet; Build-Runs zweigen auf einen eigenen Branch ab. |
EXECUTION | Der Agent arbeitet; die Live-Logs streamen in die Oberfläche. |
VALIDATION | Build-Gate (mvn verify), danach optional das Quality Gate. |
CORRECTION | Bei rotem Build speist die Fabrik das Feedback automatisch in einen erneuten Lauf ein (insgesamt höchstens zwei Korrekturläufe je Run). |
COMPLETION | Abschluss: Merge in den Basis-Branch bzw. Pull Request, Ergebnis festhalten. |
Daneben gibt es technische Status:
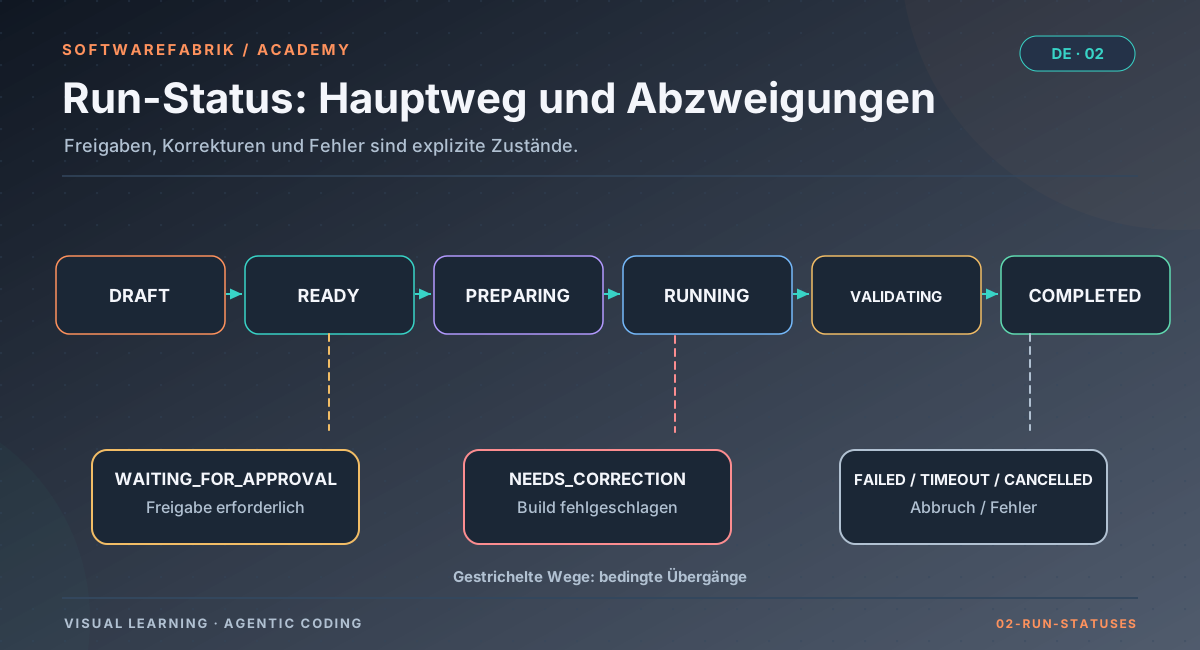
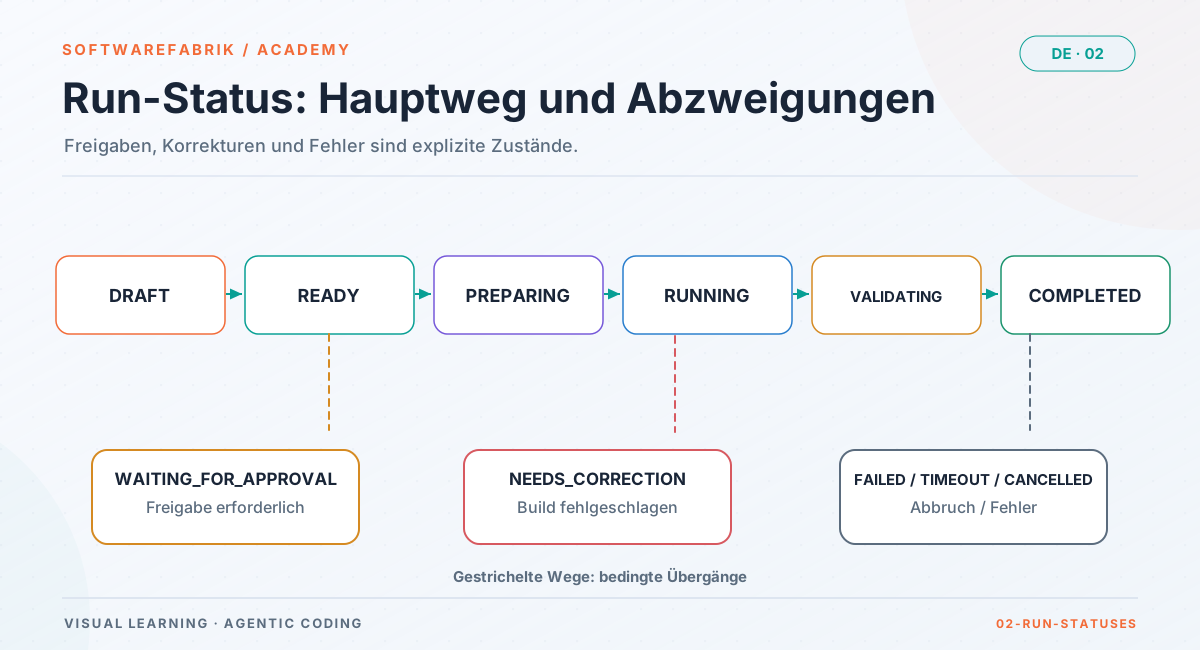
Grafik in voller Größe öffnenGrafik in voller Größe öffnen
DRAFT → READY → PREPARING → RUNNING → (WAITING_FOR_APPROVAL) → VALIDATING → COMPLETED; sowie NEEDS_CORRECTION, FAILED, TIMEOUT, CANCELLED, PAUSED und bei aktivierter PR-Rückkopplung WAITING_FOR_PR. Die Grafik zeigt den Hauptweg und die häufigsten Abzweigungen, nicht jeden Status.So bedienst du einen Run
- „Auf bereit setzen“ (
DRAFT→READY). - „Run starten“ (
READY→PREPARING): Workspace, Artefakte, Checkpoint-Commit. RUNNING: Der Agent arbeitet; die Live-Logs erscheinen per Server-Sent Events auf der Run-Detailseite.- Freigabe-Gate, falls die Policy es verlangt: Der Run wartet in
WAITING_FOR_APPROVAL. VALIDATING:mvn verify.COMPLETEDoderNEEDS_CORRECTION.
Du kannst Runs jederzeit pausieren und fortsetzen sowie abbrechen.
In der Fabrik
Freigabe-Gate und Inline-Diff
Je nach Policy greift ein Freigabe-Gate. Der Run geht dann in WAITING_FOR_APPROVAL. Auf der Run-Detailseite siehst du einen Inline-Diff der Workspace-Änderungen seit dem frühesten Checkpoint (bis 256 KB) und gibst per „Freigeben und fortsetzen“ frei. Ohne aktive Approval-Policy ist das der Normalfall: run.approval-vor-merge (Default an) lässt jeden Run vor der Ausführung auf eine Freigabe warten.
Das Administrationshandbuch kennt zwei Freigabepunkte je Build-Run:
| Punkt | Wirkung |
|---|---|
vor EXECUTION | Der Agent läuft erst nach Freigabe. Ohne Approval-Policy greift der Default run.approval-vor-merge (an). |
vor dem Merge (in VALIDATION) | Der validierte Stand wird erst nach Freigabe gemerged bzw. als Pull Request eröffnet. Aktiv nur über eine Approval-Policy (/policies) oder die Pflichtfreigabe-Phase VALIDATION in Policy-as-Code. |
Freigeben darf ab Rolle MAINTAINER; jede Entscheidung wird als attestiertes Audit-Ereignis festgehalten. Der zweite Punkt ist für regulierte Umgebungen entscheidend: Ohne ihn wäre der Code bereits im Basis-Branch, bevor jemand zugestimmt hat.
Tipp für die Freigabe: Lies den Diff wirklich. Achte besonders auf geänderte oder gelöschte Tests, neue Abhängigkeiten, Konfigurationsänderungen und Dateien, die mit dem Ziel nichts zu tun haben. Die Engineering-Guardrails verlangen vom Agenten „chirurgische“ Änderungen — jede geänderte Zeile soll sich auf das Ziel zurückführen lassen. Der Diff zeigt dir, ob er sich daran gehalten hat.
2.7 Planen und Bauen trennen
Ein häufiger Fehler beim Arbeiten mit Agenten ist, Planung und Umsetzung in einem einzigen Lauf zu vermischen: „Überleg dir, was als Nächstes sinnvoll ist, und setz es gleich um.“ Der Agent trifft dann folgenreiche Entscheidungen, ohne dass du sie vorher sehen konntest, und das Ergebnis ist schwer zu prüfen, weil Absicht und Ausführung verschmelzen.
Besser ist eine Trennung: Ein Planungslauf analysiert den Stand und schlägt Schritte vor, ohne Produktivcode zu ändern. Ein Mensch prüft die Vorschläge, wählt aus, priorisiert. Erst dann setzt ein Umsetzungslauf einen ausgewählten Schritt um. Der Plan wird so zu einem prüfbaren Zwischenergebnis — und zum Maßstab, an dem man die Umsetzung messen kann.
In der Fabrik
PLAN- und BUILD-Runs
Die Fabrik kennt zwei Arten von Runs:
| Art | Auftrag | Ergebnis |
|---|---|---|
BUILD (Default) | Setzt ein Ziel um, ändert Code, validiert per Build-Gate. | Code auf eigenem Branch sdlc/run-<id>, Merge oder Pull Request. |
PLAN | Analysiert Code, MEMORY.md und PROJECT.md und legt für jeden sinnvollen nächsten Schritt eine Datei plans/NNNN-kurz-titel.md an (Begründung, Scope, Akzeptanzkriterien, grober Aufwand). Ändert keinen Produktivcode. | Backlog-Einträge unter Backlog / Pläne. |
Einen PLAN-Run startest du aus dem Backlog des Projekts (/projects/{id}/backlog). Aktivierst du dort einen Eintrag, startet ein BUILD-Run mit dem Plan als Ziel — auf dem bestehenden Code. Den vollständigen Loop behandelt Kapitel 5.
2.8 Zugang zum Modell: Abo oder API-Key
Ein Coding-Agent braucht Zugang zu seinem Modell. Grundsätzlich gibt es zwei Wege:
- API-Key: Du bekommst vom Anbieter einen Schlüssel und zahlst nach Verbrauch, typischerweise je Million Input- und Output-Tokens. Transparent, gut für Teams und Automatisierung, aber die Kosten wachsen mit der Nutzung.
- Abonnement: Viele Anbieter erlauben, ihren Coding-Agenten mit einem persönlichen Abo zu nutzen. Man meldet sich einmal interaktiv an; die CLI speichert die Anmeldedaten lokal. Abgerechnet wird über das Abo und dessen Nutzungsgrenzen, nicht pro Token.
Welche Bedingungen für die Abo-Nutzung gelten — insbesondere für automatisierte, headless Nutzung und für die Nutzung durch mehrere Personen — legt der jeweilige Anbieter fest, und sie ändern sich. Prüfe sie vor dem Einsatz in deinem konkreten Fall. Eine wichtige technische Falle gilt aber allgemein: Ist in der Umgebung zusätzlich ein API-Key gesetzt, kann die CLI stillschweigend den kostenpflichtigen API-Pfad wählen, obwohl du das Abo nutzen wolltest.
In der Fabrik
Abo-Modus, API-Key-Modus und ephemeres HOME
Auth-Modus je Adapter
Für Claude, Codex und Kimi gibt es je einen Auth-Modus: api-key (Default) oder subscription. Er lässt sich in der .env setzen oder in der Oberfläche unter Einstellungen umschalten (wirkt ohne Neustart, maximal 5 Minuten Cache).
# Claude-Abo
SOFTWAREFABRIK_EXECUTION_ADAPTER=claude
SOFTWAREFABRIK_CLAUDECODE_AUTH_MODE=subscription

# Claude per API-Key
SOFTWAREFABRIK_EXECUTION_ADAPTER=claude
SOFTWAREFABRIK_CLAUDECODE_AUTH_MODE=api-key
ANTHROPIC_API_KEY=sk-ant-...- Im Abo-Modus entfernt die Fabrik den API-Key aktiv aus dem Subprozess (
ANTHROPIC_API_KEYbzw.OPENAI_API_KEY; bei Kimi dasKIMI_MODEL_*-Trio). Genau die Falle aus 2.8 wird damit technisch ausgeschlossen. - Einmalige Anmeldung:
claude(OAuth-Flow),codex loginoderkimi loginals derselbe Betriebssystem-Benutzer, unter dem die Fabrik läuft. Deshalb läuft der Einzelplatz hybrid: Postgres im Container, die Fabrik nativ. - Persönliche Nutzung: Der Abo-Modus ist laut Doku für die persönliche Nutzung gedacht — du als Abo-Inhaber, auf deinem Rechner, mit deinem Abo. Arbeiten mehrere Personen mit einer Instanz, gehört sie in den Betriebsmodus
TEAM_API_POOLmit API-Key bzw. Gateway. Details: Abo-Setup.
Kosten im Abo-Modus
Die Fabrik weist je Run EUR-Kosten aus, berechnet als Tokens mal Preistabelle. Im Claude-Abo-Modus ist das eine Schätzung zum API-Tarif, die nicht abgerechnet wird; die Kostenansichten kennzeichnen solche Läufe als „Schätzung (API-Tarif), nicht abgerechnet“. Kimi-Abo-Modelle führt die Kostenübersicht mit 0,00 €, weil bei der Flatrate keine Token-Kosten entstehen. Mehr dazu in Kapitel 10.
Ephemeres HOME
Erinnere dich an die tückische zweite Schicht aus 2.1: Agenten laden Konfiguration aus dem Home-Verzeichnis. Die Fabrik gibt deshalb jedem Aufruf einer Agent-CLI ein frisches, leeres HOME. Aus deinem Konfigurationsverzeichnis übernimmt sie im Abo-Modus nur die Anmeldedaten als Kopie und schreibt erneuerte Tokens nach dem Lauf zurück. Deine MCP-Server, Plugins, Hooks, settings.json/config.toml und deine Git-Identität wirken in Agentenläufen daher nicht — das ist Absicht (ADR-0017). Plugins schaltest du gezielt unter Policy-as-Code → Erlaubte Plugins frei. Warum das sicherheitsrelevant ist, vertieft Kapitel 8.
Zusammenfassung
- Ein Coding-Agent ist ein CLI-Programm: Kontext (System-Prompt, Konfiguration, Aufgabe, Verlauf) + Werkzeuge + Permissions + Modell.
- Geringste Rechte: Schreib- und Ausführungsrechte eng fassen, Prüfagenten technisch read-only machen, „alles erlauben“ nur in Wegwerf-Umgebungen.
- Headless heißt: keine Rückfragen, Permissions vorab, strukturierte Ausgabe, Zeitlimit.
- Dauerhaftes Wissen gehört in Dateien im Repository, nicht in Sitzungen.
- Die Fabrik ruft Agenten über Execution-Adapter auf und führt jeden Run durch sieben Phasen mit klaren Status, Freigabe-Gate und Inline-Diff.
- PLAN-Runs schlagen vor, BUILD-Runs setzen um.
- Im Abo-Modus strippt die Fabrik API-Keys, weist Kosten als Schätzung aus und isoliert jeden Lauf mit einem ephemeren HOME.
Übung
Übung: Einen Run von Anfang bis Ende verfolgen
Diese Übung führst du mit dem mock-Adapter durch (keine Kosten) oder in der öffentlichen Demo.
- Lege ein Projekt an (Schnell-Anlage unter
/projects/newgenügt) und erzeuge die Artefakte. - Öffne
/runs/new. Wähle den Adaptermock, ein Team und formuliere ein Ziel mit einem prüfbaren Erfolgskriterium. - Setze den Run auf bereit und starte ihn. Notiere jeden Status, den du auf der Detailseite siehst, in der Reihenfolge ihres Auftretens.
- Ordne jedem Status die Phase zu, in der er auftritt.
- Ohne Approval-Policy hält der Run vor der Ausführung in
WAITING_FOR_APPROVALan. Sieh dir den Inline-Diff an: Welche Dateien hat die Fabrik selbst geschrieben (Artefakte)? Gib dann mit „Freigeben und fortsetzen“ frei und vergleiche den Diff nach dem Lauf.
Denkaufgabe: Schreibe eine Allowlist für einen Agenten, der in einem Python-Projekt Tests ergänzen soll. Welche Werkzeuge braucht er mindestens? Welche würdest du bewusst weglassen und warum?
Lösungshinweise
Erwartbar ist die Folge DRAFT → READY → PREPARING → RUNNING → gegebenenfalls WAITING_FOR_APPROVAL → VALIDATING → COMPLETED; ohne pom.xml wird das Build-Gate übersprungen. Für die Allowlist genügen Lesen, Suchen, Dateien bearbeiten und das Testwerkzeug (etwa ein Muster für pytest) sowie lesendes Git. Weglassen solltest du Netzwerkwerkzeuge, Paketinstallation aus der Registry, Löschbefehle und schreibendes Git — Commit und Push übernimmt das umgebende System.
Kapitelfragen
-
Aus welchen Schichten besteht der Kontext eines Coding-Agenten, und welche davon ist für die Sicherheit besonders heikel?
Musterantwort
System-Prompt des Herstellers, automatisch geladene Konfiguration und Gedächtnisdateien (Home-Verzeichnis, Projekt), die Aufgabe und der Arbeitsverlauf. Heikel ist die automatisch geladene Konfiguration: Sie kann aus fremden Quellen stammen (persönliche Plugins, angebundene Dienste, Einstellungen eines importierten Repositorys) und bestimmt dann mit, was der Agent weiß und darf.
-
Warum reicht es nicht, einem Review-Agenten im Prompt zu sagen, dass er nichts ändern soll? Wie löst die Fabrik das?
Musterantwort
Eine Anweisung im Prompt kann missverstanden oder übergangen werden; eine technische Sperre nicht. Die Fabrik startet Claude-Code-Reviews mit
--permission-mode dontAskund--disallowedToolsfür Edit, Write und Bash — die Reviewer sind damit technisch read-only. -
Was ändert sich, wenn ein Agent headless statt interaktiv läuft? Nenne mindestens drei Punkte.
Musterantwort
Niemand beantwortet Rückfragen, also muss der Agent mit Unklarheiten selbst umgehen (Annahmen festhalten). Permissions müssen vorab feststehen, sonst schreibt der Agent nichts oder bittet nur im Text um Erlaubnis. Die Ausgabe sollte strukturiert (etwa JSON) sein, damit sie maschinell auswertbar ist. Und es braucht ein Zeitlimit.
-
Warum lehnt die Fabrik
--dangerously-skip-permissionsab, obwohl das den Agenten produktiver machen könnte?Musterantwort
Weil die Agent-CLI auf dem Host läuft und nicht in einer Wegwerf-VM. Ohne Permission-Prüfung könnte der Agent beliebige Befehle ausführen — Dateien löschen, Netzwerkzugriffe, Zugangsdaten lesen. Stattdessen nutzt die Fabrik
acceptEditsmit einer engen Allowlist. -
Nenne die sieben Phasen eines Runs in der richtigen Reihenfolge und erkläre, in welcher Phase das Build-Gate läuft.
Musterantwort
INTAKE,PROMPT_ASSEMBLY,WORKSPACE_PREPARATION,EXECUTION,VALIDATION,CORRECTION,COMPLETION. Das Build-Gate (mvn verify) läuft inVALIDATION; scheitert es, folgtCORRECTIONmit automatischem Feedback (bis zu zwei Versuche). -
Du nutzt den Claude-Abo-Modus, hast aber vergessen, dass in deiner Shell noch
ANTHROPIC_API_KEYgesetzt ist. Was passiert in einem Fabrik-Run, und was würde ohne die Fabrik passieren?Musterantwort
Im Abo-Modus entfernt die Fabrik den Key aktiv aus dem Subprozess; der Run läuft über das Abo. Ohne diese Maßnahme könnte die CLI den Key bevorzugen und stillschweigend über die kostenpflichtige API abrechnen. Sauberer bleibt es trotzdem, den Key gar nicht erst in der Umgebung zu haben.
-
Wozu dient die Trennung von PLAN- und BUILD-Runs?
Musterantwort
Der PLAN-Run erzeugt prüfbare Vorschläge (
plans/NNNN-*.mdmit Scope und Akzeptanzkriterien), ohne Produktivcode zu ändern. Ein Mensch wählt aus und priorisiert; erst der BUILD-Run setzt um. So werden folgenreiche Entscheidungen sichtbar, bevor sie Code werden, und die Umsetzung hat einen Maßstab. -
Ein Kollege wundert sich, dass sein persönlich eingerichteter MCP-Server in Fabrik-Runs nicht verfügbar ist. Ist das ein Fehler?
Musterantwort
Nein, das ist Absicht. Jeder Agentenaufruf bekommt ein frisches, leeres HOME; übernommen werden nur die Anmeldedaten. Persönliche MCP-Server, Plugins, Hooks und Einstellungen wirken nicht (MCP-Nullzustand, ADR-0017). Freigegebene, lesende MCP-Werkzeuge lassen sich gezielt über den MCP-Gateway bereitstellen (Kapitel 8).
-
Transfer: Dein Team will künftig ein lokales Modell statt eines Cloud-Anbieters nutzen. Was ändert sich am Prozess in der Fabrik, was bleibt gleich?
Musterantwort
Es ändert sich vor allem die Adapter-Konfiguration (
local-llmmit einem OpenAI-kompatiblen Backend wie Ollama oder vLLM) und gegebenenfalls die erwartbare Qualität und Geschwindigkeit des Modells. Gleich bleiben Projektartefakte, Guardrails, Run-Lebenszyklus, Branch je Run, Build-Gate, Quality Gate, Freigaben und Audit — genau das ist der Sinn der Adapter-Schicht.