Lernziele
Nach diesem Kapitel kannst du:
- den Unterschied erklären zwischen einem Sprachmodell (LLM), einem Chat-Assistenten und einem Coding-Agenten.
- die Agenten-Schleife beschreiben — wahrnehmen, planen, handeln, prüfen — und erkennen, an welcher Stelle sie typischerweise scheitert.
- das Kontextfenster einordnen: warum ein Agent nur weiß, was gerade „vor ihm liegt“, und was daraus für deine Arbeit folgt.
- Stärken und Grenzen benennen, insbesondere Halluzinationen, und begründen, warum Verifikation wichtiger ist als Vertrauen.
- das Leitbild der Fabrik „Du beschreibst. Die Fabrik baut. Du genehmigst.“ auf konkrete Funktionen abbilden.
- die fünf Ebenen der Fabrik (Projekt, Artefakte, Team, Run, Quality Gate) und das Rollenmodell von
VIEWERbisADMINerklären. - gefahrlos üben — mit der öffentlichen Demo oder dem
mock-Adapter, ohne Token-Kosten.
1.1 Vom Sprachmodell zum Agenten
Am Anfang jedes Coding-Agenten steht ein großes Sprachmodell (Large Language Model, LLM). Ein LLM ist, vereinfacht gesagt, eine Funktion: Es bekommt einen Text (den Prompt) und erzeugt daraus die wahrscheinlichste Fortsetzung, Stück für Stück, in sogenannten Tokens. Tokens sind Wortteile; ein deutsches Wort entspricht oft ein bis drei Tokens. Das Modell wurde auf sehr großen Mengen Text und Code trainiert und hat dabei Muster gelernt — wie man eine Java-Klasse aufbaut, wie ein REST-Endpunkt aussieht, wie man eine Fehlermeldung deutet.
Ein LLM für sich hat drei wichtige Eigenschaften, die du im Kopf behalten solltest:
- Es ist zustandslos. Zwischen zwei Aufrufen erinnert es sich an nichts. Was wie ein „Gedächtnis“ im Chat wirkt, ist in Wahrheit der bisherige Gesprächsverlauf, der bei jedem Aufruf erneut mitgeschickt wird.
- Es handelt nicht. Ein LLM kann einen Befehl wie
mvn verifyhinschreiben, aber nicht ausführen. Es sieht weder dein Dateisystem noch das Ergebnis eines Tests. - Es ist probabilistisch. Dieselbe Frage kann unterschiedliche Antworten liefern. Eine Antwort ist plausibel formuliert, aber nicht automatisch richtig.
Die drei Stufen
Es hilft, drei Stufen der Werkzeugunterstützung zu unterscheiden:
| Stufe | Was passiert | Wer handelt |
|---|---|---|
| Code-Vervollständigung | Das Modell schlägt die nächste Zeile oder Funktion im Editor vor. | Du übernimmst oder verwirfst jeden Vorschlag einzeln. |
| Chat-Assistent | Du beschreibst ein Problem, das Modell antwortet mit Erklärung und Code. Du kopierst, führst aus, meldest Fehler zurück. | Du bist die „Hand“ des Modells: Du trägst Code und Fehlermeldungen hin und her. |
| Coding-Agent | Das Modell bekommt Werkzeuge: Dateien lesen und schreiben, Befehle ausführen, suchen. Es arbeitet in einer Schleife, bis die Aufgabe erledigt ist oder es nicht weiterkommt. | Der Agent handelt selbst; du gibst das Ziel vor und prüfst das Ergebnis. |
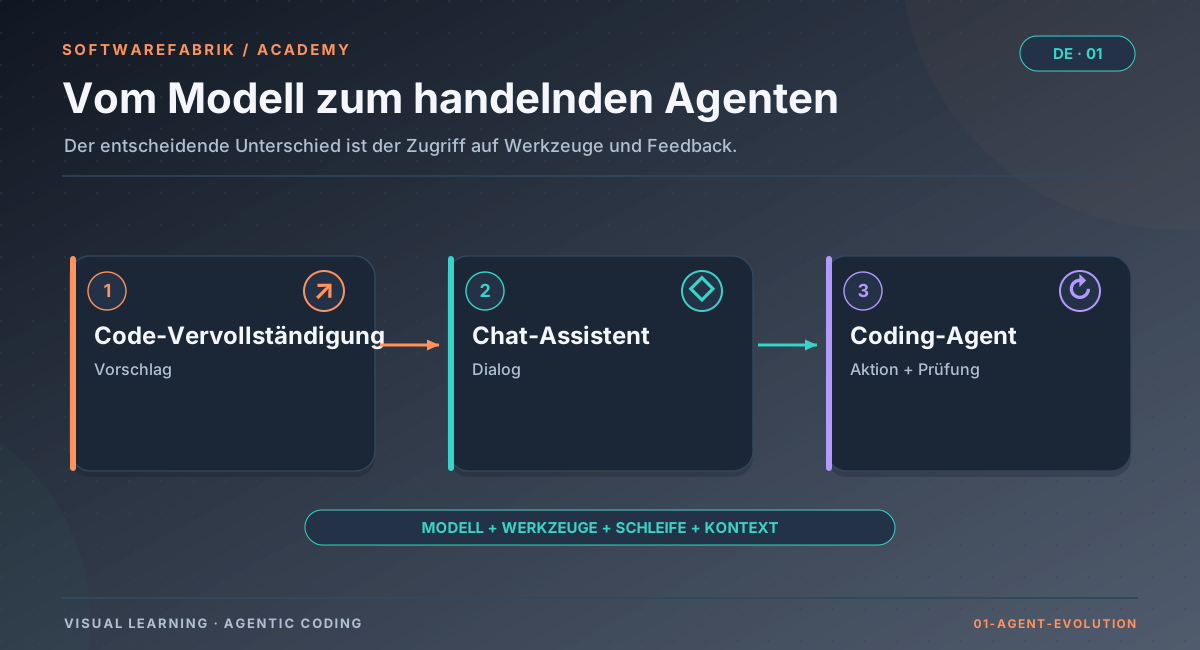
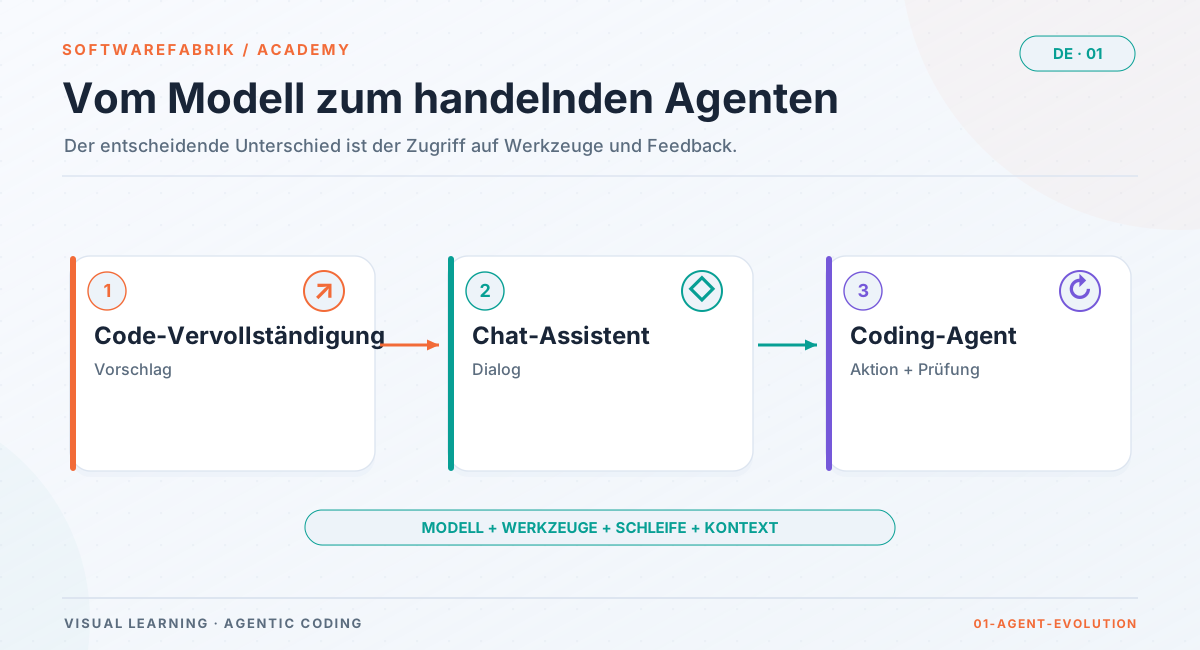
Agentic Coding bezeichnet die dritte Stufe: Softwareentwicklung, bei der ein Agent Arbeitsschritte eigenständig plant und ausführt. Der entscheidende Sprung ist nicht ein „klügeres“ Modell, sondern die Kombination aus Modell, Werkzeugen und einer Schleife, die Ergebnisse zurück ins Modell füttert. Der Agent sieht, dass sein Test rot ist, liest die Fehlermeldung und korrigiert den Code — ohne dass du dazwischen etwas kopieren musst.
1.2 Werkzeuge: Was ein Agent tun kann
Werkzeuge (englisch tools) sind Funktionen, die das Modell aufrufen darf. Technisch läuft das so: Das Modell erzeugt statt normalem Text eine strukturierte Anfrage wie „rufe Datei lesen mit dem Pfad src/main/java/App.java auf“. Die Laufzeitumgebung des Agenten — das Programm, in dem das Modell eingebettet ist — führt diesen Aufruf aus und gibt das Ergebnis als neuen Text an das Modell zurück. Das Modell selbst führt nie etwas aus; es bittet um die Ausführung.
Typische Werkzeuge eines Coding-Agenten:
- Lesen: Dateien öffnen, Verzeichnisse auflisten, nach Mustern suchen (vergleichbar mit
cat,ls,grep). - Schreiben: Dateien anlegen, gezielt ändern, löschen.
- Ausführen: Shell-Befehle starten — Build, Tests, Linter,
git status. - Nachschlagen: je nach Konfiguration Dokumentation oder Webseiten abrufen, externe Dienste ansprechen (etwa über das Model Context Protocol, MCP, mehr dazu in Kapitel 8).
Daraus folgt unmittelbar die wichtigste Sicherheitsüberlegung des ganzen Kurses: Ein Agent kann alles, was seine Werkzeuge können. Darf er beliebige Shell-Befehle ausführen, kann er auch Dateien löschen, Netzwerkverbindungen öffnen oder Zugangsdaten lesen — nicht aus Bosheit, sondern weil ein Fehler im Plan oder eine manipulierte Eingabe ihn dazu bringt. Welche Werkzeuge ein Agent bekommt und wie man das begrenzt, behandelt Kapitel 2 (Permissions) und vertieft Kapitel 8.
1.3 Die Agenten-Schleife
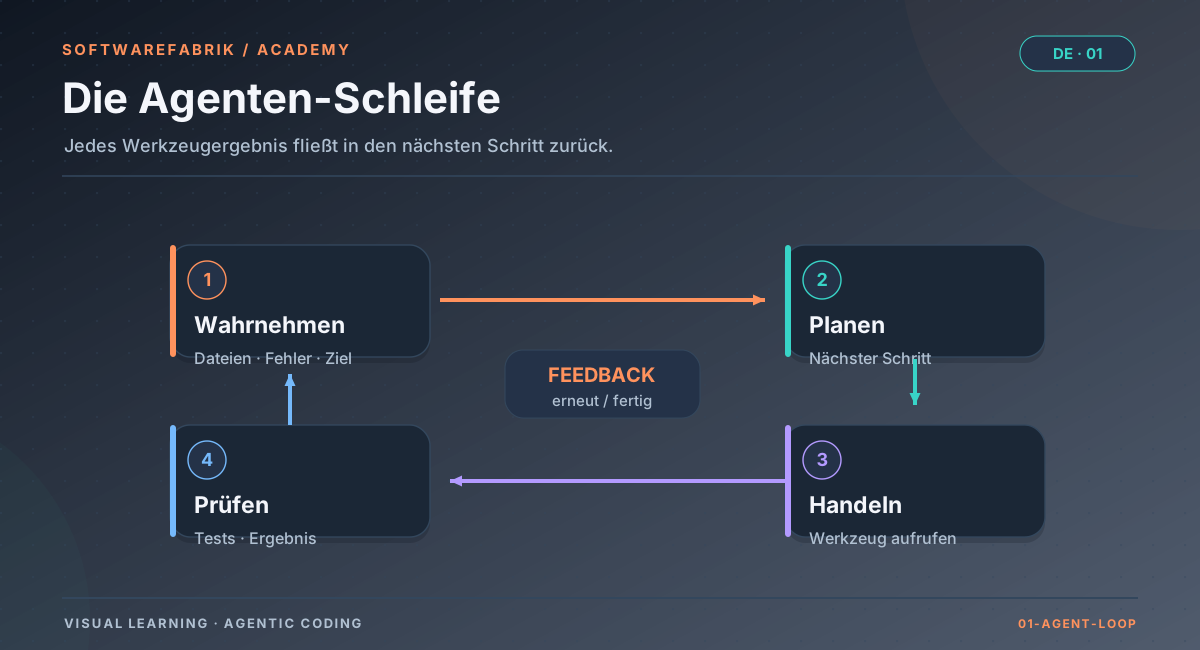
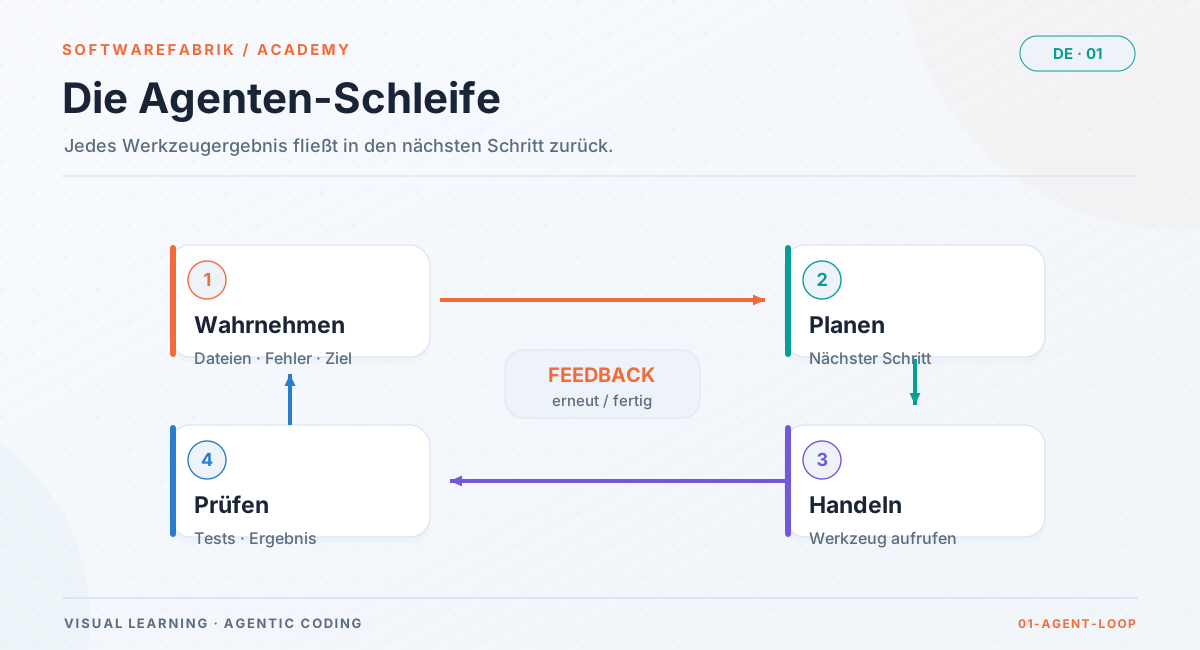
Jeder Coding-Agent folgt im Kern demselben Muster. Man kann es in vier Schritte zerlegen, die sich so lange wiederholen, bis das Ziel erreicht ist, ein Limit greift oder der Agent aufgibt:
Grafik in voller Größe öffnenGrafik in voller Größe öffnen
1. Wahrnehmen
Der Agent verschafft sich ein Bild: Er liest das Ziel, schaut sich die Projektstruktur an, öffnet relevante Dateien. Wichtig: Er sieht nur, was er aktiv liest oder was ihm mitgegeben wurde. Liegt die entscheidende Konvention in einer Datei, die er nie öffnet, existiert sie für ihn nicht.
2. Planen
Aus dem Wahrgenommenen leitet das Modell den nächsten Schritt ab. Bei einfachen Aufgaben ist das implizit („ich ändere jetzt diese Methode“), bei größeren schreibt ein guter Agent einen kurzen Plan mit Teilschritten. Hier entstehen die meisten folgenreichen Fehler: eine falsch verstandene Anforderung, eine zu große Änderung, ein übersehener Randfall.
3. Handeln
Der Agent ruft ein Werkzeug auf: Er schreibt Code, legt eine Datei an, startet den Build. Jede Handlung verändert die Welt — mindestens den Arbeitsstand im Repository.
4. Prüfen
Das Ergebnis der Handlung fließt zurück: Kompiliert es? Sind die Tests grün? Was sagt der Linter? Ist das Ziel erreicht, endet die Schleife. Sonst beginnt sie mit den neuen Informationen von vorn.
Wo die Schleife scheitert
Die Schleife ist nur so gut wie ihr Prüfschritt. Drei typische Fehlerbilder:
- Prüfung fehlt: Gibt es keine Tests, kann der Agent nur prüfen, ob der Code kompiliert. „Kompiliert“ heißt nicht „tut das Richtige“.
- Prüfung wird umgangen: Ein Agent, der um jeden Preis grüne Tests erreichen will, kann einen Test abschwächen oder auskommentieren, statt den Fehler zu beheben. Das ist kein böser Wille, sondern der kürzeste Weg zum formalen Ziel.
- Endlosschleife ohne neue Information: Der Agent versucht immer wieder dasselbe. Gute Systeme begrenzen deshalb die Zahl der Versuche und verlangen, dass jeder neue Versuch auf neuer Information beruht (etwa einer anderen Fehlermeldung).
Aus diesen Fehlerbildern folgt eine Grundhaltung, die sich durch den ganzen Kurs zieht: Der Prüfschritt darf nicht allein beim Agenten liegen. Es braucht eine unabhängige Verifikation — einen Build, den der Agent nicht beeinflussen kann, Reviewer, die nichts ändern dürfen, und am Ende einen Menschen, der freigibt.
In der Fabrik
Das Leitbild: Du beschreibst. Die Fabrik baut. Du genehmigst.
Die SoftwareFabrik nimmt die Agenten-Schleife ernst und baut einen kontrollierten Prozess darum herum. Sie ist eine lokale Control Plane für KI-gestützte Softwareentwicklung: Statt einen Coding-Agenten (Claude Code, OpenAI Codex, Gemini, Aider und weitere) direkt in der Shell zu bedienen, beschreibst du dein Vorhaben strukturiert in einer Web-Oberfläche. Die Fabrik baut daraus präzise Eingabe-Artefakte, startet überwachte Runs, sammelt Logs, Tokens und Kosten und erzwingt Git-Disziplin und ein Build-Gate.
Das Leitbild der Startseite fasst die Arbeitsteilung in drei Sätzen:
| Satz | Was du tust | Was die Fabrik dafür bereitstellt |
|---|---|---|
| Du beschreibst. | Projekt, Ziele, Anforderungen und Leitplanken formulieren. | Projekt-Assistent (/wizard), Projektdefinition mit 13 Feldern, generierte Markdown-Artefakte, optional Specs mit Akzeptanzkriterien. |
| Die Fabrik baut. | Einen Run anstoßen und mitverfolgen. | Isolierter Workspace, eigener Branch je Build-Run, Agent als Subprozess, Live-Logs, mvn verify als Build-Gate, automatische Korrekturschleife. |
| Du genehmigst. | Ergebnis prüfen und freigeben — oder ablehnen. | Freigabe-Gate mit Inline-Diff, Quality Gate mit Reviewern, Pull Request, signierte Audit-Kette. |
Beachte, wie sich die vier Schritte der Agenten-Schleife darin wiederfinden: Wahrnehmen und Planen werden durch gute Artefakte gefüttert, das Handeln findet isoliert im Workspace statt, und das Prüfen wird nicht dem Agenten allein überlassen, sondern durch Build-Gate, Quality Gate und deine Freigabe abgesichert.
1.4 Das Kontextfenster: Was der Agent „weiß“
Weil ein LLM zustandslos ist, muss bei jedem Schritt der Schleife alles Relevante erneut mitgeschickt werden: die Systemanweisungen, dein Ziel, der bisherige Verlauf, die gelesenen Dateien, die Ausgaben der Werkzeuge. Dieser gesamte Text heißt Kontext, und seine maximale Länge ist das Kontextfenster. Es wird in Tokens gemessen und ist je nach Modell unterschiedlich groß — aber immer endlich.
Das hat konkrete Folgen:
- Der Agent weiß nur, was im Kontext steht. Sein trainiertes Allgemeinwissen kennt keine Details deines Projekts. Deine Namenskonventionen, deine Architekturentscheidung von letzter Woche, die Tatsache, dass Migrationen nie geändert werden dürfen — all das muss in den Kontext.
- Der Kontext füllt sich. Jede gelesene Datei, jede lange Build-Ausgabe kostet Platz. Bei langen Aufgaben werden ältere Teile gekürzt oder zusammengefasst; Details können dabei verloren gehen.
- Mehr ist nicht automatisch besser. Ein überladener Kontext mit vielen irrelevanten Dateien lenkt ab. Präziser, gut strukturierter Kontext schlägt große Mengen.
- Kontext kostet. Bei Abrechnung nach Tokens zahlst du für jeden Token, der ins Modell geht — bei jedem Schleifendurchlauf erneut, soweit kein Caching greift. Mehr dazu in Kapitel 10.
- Sitzungen enden. Was der Agent in einer Sitzung gelernt hat, ist in der nächsten weg, wenn es nicht irgendwo festgehalten wurde — in Dateien, im Repository, in einem Projekt-Gedächtnis.
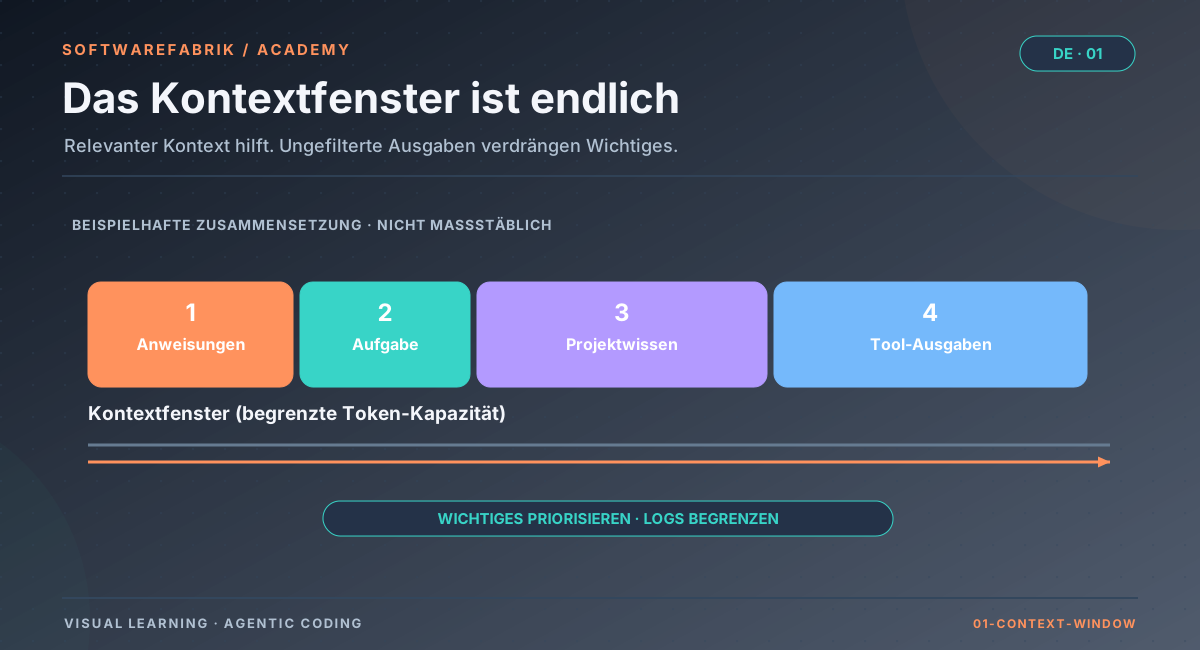
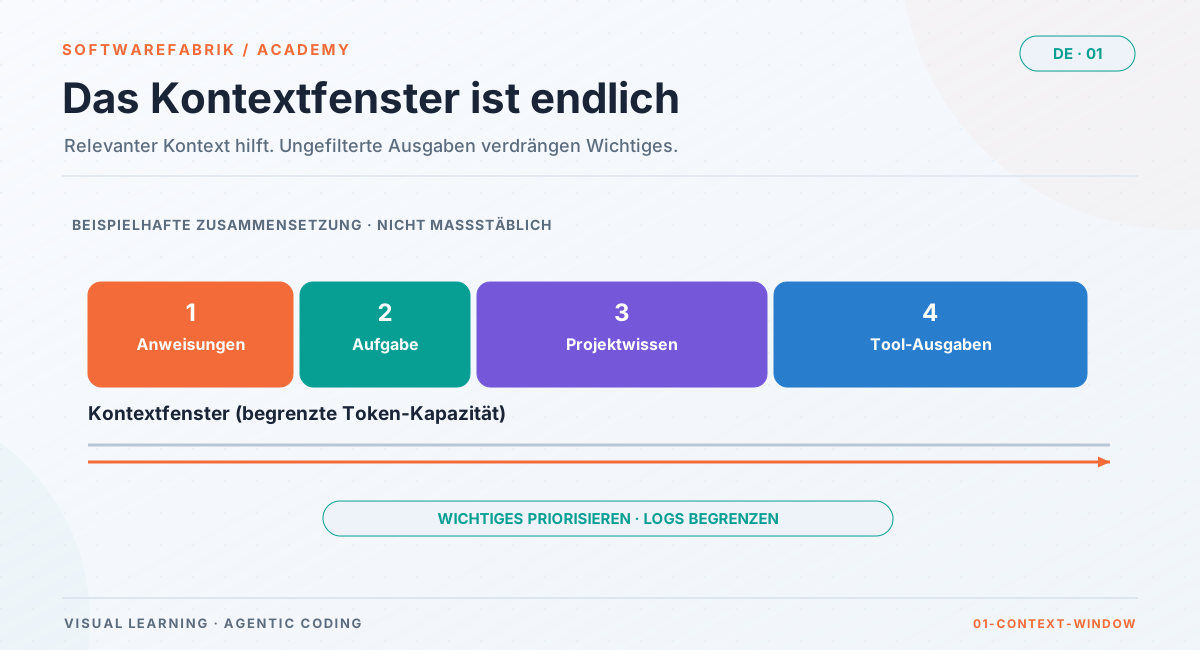
Daraus ergibt sich die zentrale Erkenntnis von Kapitel 3: Kontext ist alles. Die Qualität eines Agentenlaufs hängt weniger vom Modell ab als davon, was du ihm mitgibst.
In der Fabrik
Fünf Ebenen: wie die Fabrik Kontext und Kontrolle ordnet
Die Fabrik denkt in fünf Ebenen. Wer sie versteht, findet sich in der Oberfläche sofort zurecht — und sieht, wie jede Ebene ein Problem aus diesem Kapitel adressiert:
| Ebene | Inhalt | Löst welches Problem? |
|---|---|---|
| Projekt | Idee, Zielbild, Anforderungen — zuerst als Entwurf, angelegt über den Assistenten (/wizard) oder schnell über /projects/new. | Der Agent kennt dein Vorhaben nicht von selbst. |
| Artefakte | Generierte Markdown-Dateien wie PROJECT.md, INSTRUCTIONS.md, AGENTS.md, WORKFLOW.md, DEFINITION_OF_DONE.md, README.md. | Kontext muss schriftlich, vollständig und versioniert vorliegen. |
| Team | Zusammenstellung von Agentenrollen (Architect, Developer, Reviewer, QA, Security Reviewer, Documentation, Merge/Release) mit Leitplanken und Modellzuordnung, gepflegt unter /agents und /teams. | Unterschiedliche Aufgaben brauchen unterschiedliche Anweisungen und Grenzen. |
| Run | Eine konkrete, überwachte Ausführung mit Status, Phasen, Logs, Token-Verbrauch und Kosten. | Handeln findet kontrolliert, isoliert und nachvollziehbar statt. |
| Quality Gate | Automatische Bewertung des Ergebnisses durch mehrere read-only Reviewer. | Der Prüfschritt darf nicht allein beim Agenten liegen. |
Der Merksatz aus der Einführung gilt auch hier: Gute Runs beginnen mit guten Artefakten. Plane bewusst, bevor du zum ersten Mal auf „Run starten“ klickst.
1.5 Stärken und Grenzen
Coding-Agenten sind weder Wundermittel noch Spielzeug. Wer sie sinnvoll einsetzen will, braucht ein realistisches Bild.
Wo Agenten stark sind
- Gut beschriebene, abgegrenzte Aufgaben: „Füge einen Endpunkt hinzu, der X tut, mit Validierung Y und Tests für Z.“ Je klarer das Ziel und je prüfbarer das Ergebnis, desto besser.
- Bekannte Muster: CRUD-Funktionen, Boilerplate, Projekt-Skelette, Konfiguration gängiger Frameworks, Migration zwischen Versionen nach dokumentierten Regeln.
- Mechanische Breitenarbeit: dieselbe Änderung an vielen Stellen, Umbenennungen, Tests für bestehenden Code ergänzen, Dokumentation nachziehen.
- Erkunden: sich in eine unbekannte Codebasis einlesen, Zusammenhänge erklären, Varianten skizzieren.
- Ausdauer: Ein Agent wird nicht müde, liest auch die zwanzigste Fehlermeldung vollständig und probiert systematisch.
Wo Agenten schwach sind
- Unklare Ziele: Ein Agent füllt Lücken mit Annahmen — plausibel, aber nicht unbedingt deine. Er baut dann sauber das Falsche.
- Implizites Wissen: fachliche Regeln, die nirgends stehen, politische Rücksichten im Team, „das haben wir schon einmal versucht“.
- Große, querschnittliche Entscheidungen: Architekturwechsel, Sicherheitskonzepte, Datenmodelle mit langer Lebensdauer. Hier ist der Agent ein guter Gesprächspartner, aber kein Entscheider.
- Selbstkritik: Ein Agent, der seinen eigenen Code bewertet, neigt dazu, ihn für gut zu halten. Deshalb trennt man Schreiben und Prüfen.
- Lange Aufgaben ohne Zwischenprüfung: Fehler in frühen Schritten pflanzen sich fort, der Kontext läuft voll, die Richtung driftet.
Halluzinationen
Als Halluzination bezeichnet man Ausgaben, die plausibel klingen, aber nicht stimmen. Beim Programmieren äußern sie sich typischerweise so:
- Aufruf einer Methode oder Klasse, die es nicht gibt — etwa eine Bibliotheksfunktion, die „so heißen müsste“.
- Erfundene Konfigurationsschlüssel, Kommandozeilen-Optionen oder API-Felder.
- Falsche Erfolgsmeldungen: „Alle Tests laufen durch“, obwohl keine Tests ausgeführt oder geändert wurden.
- Platzhalter statt Lösung:
// TODO: implementierenin einer Methode, die als fertig gemeldet wird. - Erfundene Begründungen: eine überzeugend klingende Erklärung für ein Verhalten, das in Wahrheit eine andere Ursache hat.
Halluzinationen sind kein seltener Defekt, den das nächste Modell behebt, sondern eine Folge des Funktionsprinzips: Das Modell erzeugt wahrscheinlichen Text, nicht geprüften. Werkzeuge mildern das erheblich — ein Agent, der den Compiler laufen lässt, merkt, dass die erfundene Methode nicht existiert. Aber nur, wenn er die Prüfung auch ausführt und ehrlich auswertet.
1.6 Vertrauen ist kein Prozess: Verifikation
Die naheliegende Frage lautet: „Kann ich dem Agenten vertrauen?“ Sie ist falsch gestellt. Auch menschlichen Kolleginnen und Kollegen vertraut man in professioneller Softwareentwicklung nicht blind — man hat Code-Reviews, CI-Pipelines, Tests, Vier-Augen-Prinzip. Die richtige Frage lautet: Wie stelle ich sicher, dass falsche Ergebnisse auffallen, bevor sie Schaden anrichten?
Die Antwort besteht aus mehreren Schichten, die sich ergänzen:
- Prüfbare Ziele: Was „fertig“ heißt, steht vorher fest — idealerweise als Akzeptanzkriterien, aus denen sich Tests ableiten lassen (Kapitel 4).
- Automatische Prüfung, die der Agent nicht steuert: ein Build, der außerhalb der Agentenschleife läuft und dessen Ergebnis nicht verhandelbar ist.
- Unabhängige Reviews: Prüfer, die den Code lesen, aber nicht ändern dürfen — statische Analysen und weitere Modelle.
- Menschliche Freigabe: Bevor etwas in den Hauptzweig oder in Produktion geht, schaut ein Mensch auf den Diff.
- Nachvollziehbarkeit: Später lässt sich belegen, was passiert ist, wer zugestimmt hat und warum (Kapitel 9).
In der Fabrik
Verifikation eingebaut: Build-Gate, Reviewer, Freigabe
Die Fabrik setzt die Schichten aus 1.6 als festen Bestandteil jedes Runs um. Einen Überblick bekommst du hier, die Details folgen in Kapitel 6.
- Build-Gate: In der Phase
VALIDATIONführt die Fabrik selbstmvn verifyaus (Java-zentriert; ohnepom.xmlwird der Schritt übersprungen). Ist der Build rot, geht der Run inNEEDS_CORRECTIONund die Fabrik speist das Build-Feedback automatisch in einen erneuten Lauf auf demselben Branch ein — bis zu zwei Versuche. - Quality Gate mit read-only Reviewern: Sechs Reviewer prüfen das Ergebnis, ohne je in den Workspace zu schreiben. Einer davon,
hallucination-reviewer, sucht gezielt nach den Halluzinationsmustern aus 1.5: erfundene Klassen und Methoden, TODO-Marker und die Behauptung „Tests laufen durch“ ohne Teständerung. - Kein stiller Erfolg: Stürzt ein Reviewer ab, lautet das Urteil
ERROR— nie stillschweigend „bestanden“. - Freigabe-Gate: Je nach Policy wartet ein Run in
WAITING_FOR_APPROVAL, bis ein Mensch mit ausreichender Rolle den Inline-Diff gesehen und freigegeben hat. - Branch-Isolation: Jeder Build-Run arbeitet auf einem eigenen Branch
sdlc/run-<id>. Scheitert er, bleibt der Basis-Branch sauber.
Damit wird aus „Ich hoffe, der Agent hat recht“ ein Prozess, in dem falsche Ergebnisse mit hoher Wahrscheinlichkeit auffallen — und in dem du die letzte Entscheidung triffst.
1.7 Die Rolle des Menschen
Agentic Coding verschiebt die Arbeit des Menschen, es ersetzt sie nicht. Man kann die menschlichen Aufgaben in vier Tätigkeiten gliedern:
- Beschreiben: Was soll entstehen, für wen, mit welchen Randbedingungen? Diese Arbeit war schon immer der schwierigste Teil der Softwareentwicklung — mit Agenten wird sie noch wichtiger, weil Unklarheiten nicht mehr in der Kaffeeküche geklärt, sondern vom Agenten mit Annahmen gefüllt werden.
- Steuern: Aufgaben schneiden, Reihenfolge festlegen, das passende Werkzeug und Modell wählen, Budgets setzen.
- Prüfen und freigeben: Diffs lesen, Testergebnisse bewerten, Befunde der Reviewer einordnen, Ja oder Nein sagen.
- Verantworten: Am Ende steht ein Mensch für das Ergebnis ein — gegenüber Team, Kunden und gegebenenfalls Aufsicht.
In Teams verteilen sich diese Tätigkeiten auf verschiedene Personen. Ein bewährtes Prinzip aus regulierten Umgebungen ist die Funktionstrennung (Segregation of Duties): Wer eine Änderung auslöst, gibt sie nicht selbst frei. Mit Agenten gewinnt dieses Prinzip an Bedeutung, weil der „Autor“ des Codes eine Maschine ist und die menschliche Freigabe die eigentliche Qualitätsentscheidung darstellt.
In der Fabrik
Rollen: wer beschreibt, wer baut lassen darf, wer freigibt
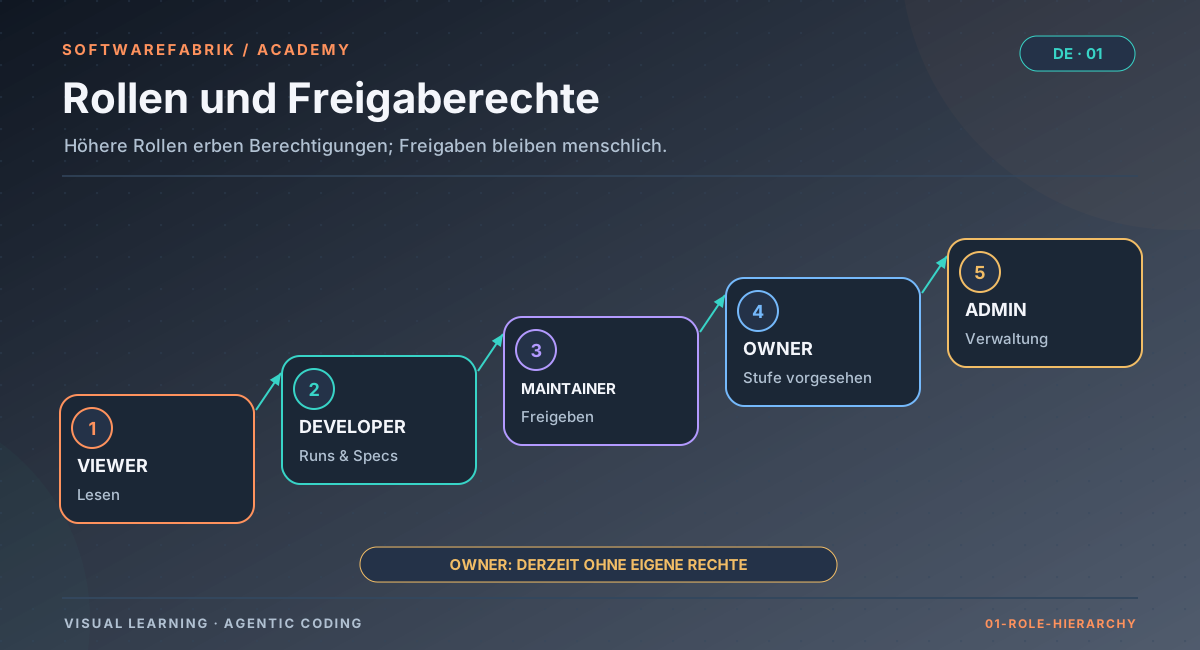
Im Mehrbenutzerbetrieb arbeitet die Fabrik mit einem gestuften Rollenmodell. Jede höhere Rolle umfasst die Rechte der niedrigeren:
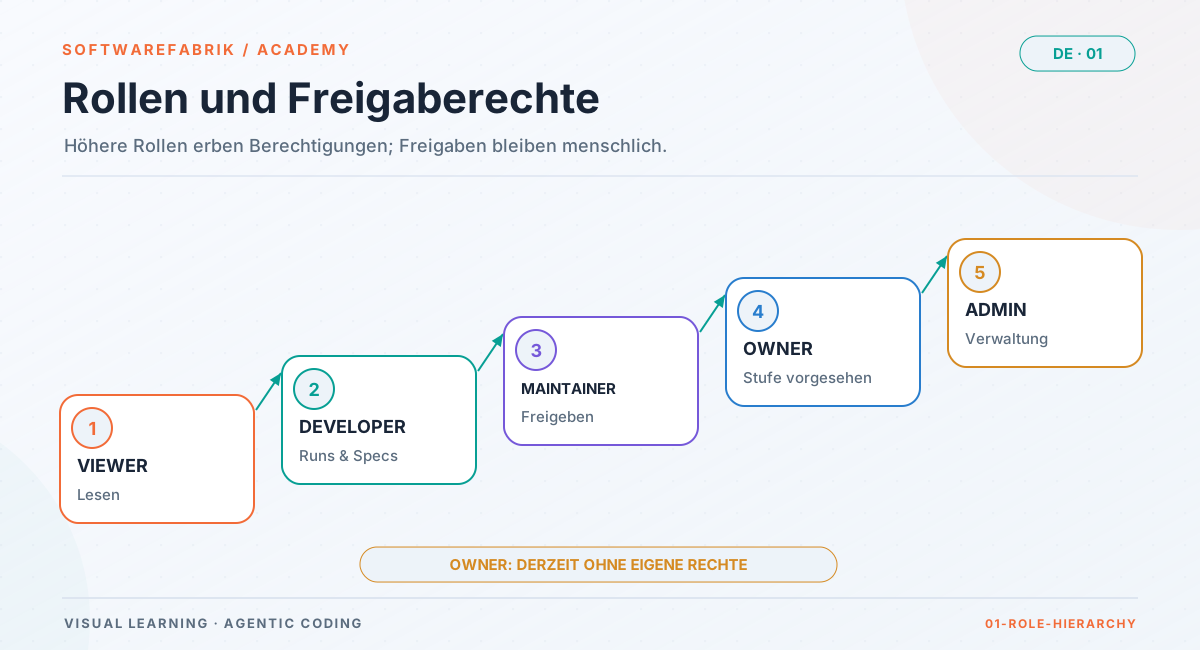
Grafik in voller Größe öffnenGrafik in voller Größe öffnen
| Fähigkeit | ab Rolle | Bezug zum Leitbild |
|---|---|---|
| lesen (Projekte, Runs, Logs) | VIEWER | Mitlesen, nachvollziehen |
| Runs ausführen, Specs anlegen und bearbeiten | DEVELOPER | Du beschreibst, die Fabrik baut |
| Runs freigeben, Specs freigeben, Integrationen/Secrets verwalten | MAINTAINER | Du genehmigst |
| Mandanten-Administration | ADMIN (die Stufe OWNER ist im Rollenmodell vorgesehen, trägt derzeit aber keine eigenen Rechte) | Organisation |
| Konten, Policy-as-Code, Compliance-Profile, Attestierung, Export | ADMIN | Betrieb und Nachweis |
Zwei Details sind bemerkenswert:
- Segregation of Duties ist einstellbar: Mit
run.approval-segregationdarf derjenige, der einen Run ausgelöst hat, ihn nicht selbst freigeben. Ohne aktive Approval-Policy hält jeder Run standardmäßig vor der Ausführung auf eine menschliche Freigabe an (run.approval-vor-merge, Default an); eine Pflichtfreigabe vor dem Merge verlangst du über eine Approval-Policy bzw. die Pflichtfreigabe-Phasen in Policy-as-Code. ADMINist kein Super-Admin für Daten. Auch ein Administrator bleibt für Projekte, Runs, Logs und Kosten an seinen Mandanten gebunden. Isolationsfrei sind nur Kontenverwaltung und Projektzuweisung.
Arbeitest du allein im Einzelplatz-Betrieb, hast du als Bootstrap-Admin alle Rollen in einer Person. Das Prinzip bleibt trotzdem nützlich: Nimm dir die Freigabe bewusst als eigenen Schritt vor, statt sie durchzuklicken.
1.8 Wann lohnt sich Agentic Coding — und wann nicht?
Eine einfache Faustregel: Agenten lohnen sich dort, wo das Ziel klar beschreibbar und das Ergebnis automatisch prüfbar ist. Beides lässt sich bewusst herstellen — durch gute Beschreibung und durch Tests. Die folgende Matrix hilft bei der Einordnung:
| Ergebnis gut prüfbar | Ergebnis schwer prüfbar | |
|---|---|---|
| Ziel klar | Idealer Einsatz: Agent arbeitet, Prüfung fängt Fehler. | Machbar, aber erst Prüfbarkeit schaffen (Tests, Akzeptanzkriterien). |
| Ziel unklar | Zuerst Ziel schärfen — Agent kann dabei helfen (Entwürfe, Fragen, Varianten). | Nicht delegieren. Erst klären, dann zerlegen. |
Daraus folgt der Aufbau dieses Kurses: Kapitel 3 und Kapitel 4 machen Ziele klar, Kapitel 5 zerlegt sie, Kapitel 6 macht Ergebnisse prüfbar.
In der Fabrik
Gefahrlos üben: Demo und mock-Adapter
Bevor du echte Tokens ausgibst oder einen Agenten auf echten Code loslässt, lohnt es sich, den Ablauf kennenzulernen. Dafür gibt es zwei Wege:
Die öffentliche Demo
Unter demo.softwarefabrik.io läuft eine lizenzfreie Instanz. Du bist dort automatisch als Demo-Nutzer angemeldet, siehst den vollen Funktionsumfang, aber Aufrufe an Modellanbieter sind deaktiviert. Datenbank und Workspaces werden täglich um 04:00 Uhr UTC zurückgesetzt — ideal zum Herumklicken, nichts für dauerhafte Daten.
Der mock-Adapter in deiner eigenen Installation
Hast du die Fabrik lokal installiert (siehe Schnellstart), stellst du den Ausführungsadapter auf mock:
SOFTWAREFABRIK_EXECUTION_ADAPTER=mock.env des Einzelplatz-Pakets.Damit durchläufst du den kompletten Run-Ablauf — Projekt anlegen, Run starten, Phasen beobachten, Freigabe, Quality Gate — ohne echten Agenten und ohne Kosten. Das Benutzerhandbuch empfiehlt genau das, um die Oberfläche und den Lebenszyklus kennenzulernen, bevor du echtes Geld oder Abo-Kontingent einsetzt.
mock-Adapter durch. Erst wenn du den Ablauf verstanden hast, wechselst du auf einen echten Adapter.
Zusammenfassung
- Ein LLM erzeugt Text; ein Agent kombiniert Modell, Werkzeuge, Schleife und Kontext und handelt dadurch selbst.
- Die Agenten-Schleife — wahrnehmen, planen, handeln, prüfen — ist nur so gut wie ihr Prüfschritt.
- Das Kontextfenster ist endlich; der Agent weiß nur, was darin steht. Projektwissen muss schriftlich mitgegeben werden.
- Halluzinationen sind eine Folge des Funktionsprinzips. Sie werden nicht durch Vertrauen, sondern durch Verifikation beherrscht.
- Die Fabrik übersetzt das in ihr Leitbild: Du beschreibst. Die Fabrik baut. Du genehmigst. — mit fünf Ebenen (Projekt, Artefakte, Team, Run, Quality Gate) und einem Rollenmodell, das Beschreiben, Ausführen und Freigeben trennt.
- Üben kostet nichts: Demo oder
mock-Adapter.
Übung
Übung: Eine Aufgabe auf Agenten-Tauglichkeit prüfen
Nimm drei Aufgaben aus deinem aktuellen Arbeitsalltag (oder nutze die Beispiele unten) und bewerte jede anhand der Matrix aus 1.8.
- „Füge dem Kundenservice eine Suche nach Postleitzahl hinzu.“
- „Mach die Anwendung schneller.“
- „Ersetze in allen Modulen die veraltete Datumsbibliothek durch
java.time; bestehende Tests müssen grün bleiben.“
Beantworte für jede Aufgabe schriftlich:
- Ist das Ziel klar? Welche Information fehlt dem Agenten?
- Wie würdest du prüfen, dass das Ergebnis richtig ist? Gibt es schon Tests, oder müssten sie entstehen?
- Welche Halluzination wäre bei dieser Aufgabe besonders wahrscheinlich?
- Wer sollte das Ergebnis freigeben?
Praxisteil: Öffne die Demo oder deine lokale Installation mit dem mock-Adapter. Finde die fünf Ebenen in der Navigation wieder (Projekte, Artefakte eines Projekts, Teams, Runs, Quality Gate eines Runs) und notiere dir zu jeder Ebene die URL.
Lösungshinweise
Aufgabe 1 ist mittelgut: Das Ziel ist grob klar, aber es fehlt, wo die Suche erscheint, ob Teiltreffer zählen und was bei ungültiger Eingabe passiert — typische Kandidaten für Akzeptanzkriterien. Aufgabe 2 ist ohne Messgröße nicht delegierbar: „schneller“ ist nicht prüfbar, zuerst braucht es ein messbares Ziel (etwa eine Antwortzeit für einen bestimmten Endpunkt). Aufgabe 3 ist gut geeignet: klares Ziel, mechanische Breitenarbeit und eine vorhandene Prüfung (bestehende Tests); wahrscheinliche Halluzination sind erfundene Methoden der neuen API oder abgeschwächte Tests. Freigeben sollte jeweils jemand, der den Diff tatsächlich liest — in der Fabrik ab Rolle MAINTAINER.
Kapitelfragen
-
Was unterscheidet einen Coding-Agenten von einem Chat-Assistenten, der ebenfalls Code erzeugt?
Musterantwort
Der Chat-Assistent erzeugt nur Text; du führst den Code aus und trägst Fehlermeldungen zurück. Der Agent hat Werkzeuge (Dateien lesen und schreiben, Befehle ausführen) und arbeitet in einer Schleife: Er sieht die Ergebnisse seiner Handlungen selbst und reagiert darauf. Das Modell kann dasselbe sein — der Unterschied liegt in Werkzeugen, Schleife und Kontextversorgung.
-
Nenne die vier Schritte der Agenten-Schleife und erkläre, warum der vierte Schritt der kritischste ist.
Musterantwort
Wahrnehmen, planen, handeln, prüfen. Der Prüfschritt entscheidet, ob ein Fehler bemerkt wird. Fehlt eine echte Prüfung (keine Tests), wird sie umgangen (Test abgeschwächt) oder wertet der Agent sie geschönt aus, läuft die Schleife scheinbar erfolgreich zu Ende, obwohl das Ergebnis falsch ist.
-
Ein Agent hält sich nicht an eure Regel, dass Datenbankmigrationen nie nachträglich geändert werden. Welche Ursache ist am wahrscheinlichsten, und was tust du?
Musterantwort
Wahrscheinlich stand die Regel nicht im Kontext — der Agent kennt sie schlicht nicht. Abhilfe: die Regel schriftlich in die Projektartefakte bzw. Leitplanken aufnehmen (Kapitel 3) und zusätzlich automatisch prüfen. In der Fabrik meldet der Reviewer
architecture-reviewerÄnderungen an bestehenden Flyway-Migrationen als CRITICAL. -
Warum verschwinden Halluzinationen nicht einfach mit besseren Modellen?
Musterantwort
Weil ein Sprachmodell wahrscheinlichen, nicht geprüften Text erzeugt. Bessere Modelle halluzinieren seltener, aber das Prinzip bleibt. Beherrschbar werden Halluzinationen durch Werkzeuge, die die Realität zurückmelden (Compiler, Tests), und durch unabhängige Prüfung.
-
Ordne die drei Sätze des Leitbilds „Du beschreibst. Die Fabrik baut. Du genehmigst.“ jeweils mindestens einer konkreten Funktion der Fabrik zu.
Musterantwort
Beschreiben: Projekt-Assistent unter
/wizard, Projektdefinition, generierte Artefakte wiePROJECT.md, Specs. Bauen: Run mit isoliertem Workspace, eigenem Branch, Live-Logs, Build-Gatemvn verify, Korrekturschleife. Genehmigen: Freigabe-Gate mit Inline-Diff (WAITING_FOR_APPROVAL), Quality Gate, Pull Request. -
Welche Rolle braucht jemand in der Fabrik mindestens, um einen Run freizugeben, und was bewirkt die Einstellung
run.approval-segregation?Musterantwort
Freigeben darf ab Rolle
MAINTAINER. Mitrun.approval-segregationgilt Funktionstrennung: Wer den Run ausgelöst hat, darf ihn nicht selbst freigeben. So entsteht ein echtes Vier-Augen-Prinzip. -
Eine Kollegin sagt: „Der Agent hat am Ende geschrieben, dass alle Tests grün sind — wir können mergen.“ Was entgegnest du?
Musterantwort
Die Zusammenfassung des Agenten ist eine Behauptung, kein Nachweis. Maßgeblich ist das Ergebnis eines Builds, den der Agent nicht steuert, plus Review und Freigabe. In der Fabrik prüft die Phase
VALIDATIONden Build selbst, undhallucination-reviewererkennt gezielt Erfolgsbehauptungen ohne Teständerung. -
Du willst einem neuen Teammitglied die Fabrik zeigen, ohne Kosten zu verursachen. Welche zwei Möglichkeiten hast du, und worin unterscheiden sie sich?
Musterantwort
Die öffentliche Demo unter
demo.softwarefabrik.io(automatischer Demo-Login, Vendor-Aufrufe deaktiviert, tägliches Zurücksetzen) oder eine eigene Installation mitSOFTWAREFABRIK_EXECUTION_ADAPTER=mock. Die Demo braucht keine Installation; der Mock-Adapter läuft in deiner eigenen Umgebung mit deinen Daten und deiner Konfiguration und behält sie. -
Transfer: Welche Aufgaben in deinem Team würdest du heute nicht an einen Agenten delegieren, und was müsste sich ändern, damit es ginge?
Musterantwort
Typische Kandidaten sind Aufgaben mit unklarem Ziel („besser machen“) oder ohne Prüfmöglichkeit (Code ohne Tests, rein visuelle Anforderungen). Damit sie delegierbar werden, braucht es ein messbares Ziel, Akzeptanzkriterien und automatische Prüfungen — oder eine Zerlegung in kleinere, prüfbare Teilaufgaben. Große Architekturentscheidungen bleiben beim Menschen; der Agent kann Varianten vorbereiten.