Lernziele
Nach diesem Kapitel kannst du …
- erklären, warum der Kontext die wichtigste Stellschraube für die Ergebnisqualität eines Coding-Agenten ist und was „Müll rein, Müll raus“ bei Agenten konkret bedeutet.
- unterscheiden, welche Arten von Kontext es gibt: Projektbeschreibung, Konventionen, Leitplanken, Gedächtnis, Auftrag und Akzeptanzkriterien.
- einschätzen, wie ein begrenztes Kontextbudget deine Entscheidungen beeinflusst: was hineingehört, was nicht, und wie Widersprüche entstehen.
- beschreiben, was
AGENTS.mdals werkzeugübergreifende Konvention leistet und warum eine Quelle mit mehreren Projektionen besser ist als eine Kopie je Werkzeug. - in der Fabrik ein Projekt mit dem Projekt-Assistenten anlegen, die 13 Felder der Projektdefinition sinnvoll füllen, die generierten Artefakte prüfen und bearbeiten, Project-Memory pflegen und ein Team aus Agentenrollen zusammenstellen.
- nachvollziehen, wie die Engineering-Guardrails in jeden Run gelangen, wie sie gegenüber Projektvorgaben gewichtet werden und wie ihr Einsatz attestiert wird.
3.1 Warum Kontext über Qualität entscheidet
Ein Sprachmodell hat kein Gedächtnis zwischen zwei Aufrufen und kein Wissen über dein Projekt, das nicht im Aufruf selbst steht. Was es über deine Anwendung „weiß“, stammt aus genau zwei Quellen: aus seinem allgemeinen Training (Sprachen, Frameworks, verbreitete Muster) und aus dem, was im Kontextfenster dieses einen Laufs liegt. Ein Coding-Agent erweitert das Kontextfenster zwar selbst, indem er Dateien liest, Befehle ausführt und Ergebnisse auswertet (siehe Kapitel 2). Aber was er liest, wonach er sucht und wie er das Gefundene gewichtet, hängt davon ab, womit du ihn startest.
Das klingt banal, hat aber weitreichende Folgen. Stell dir vor, du gibst einem erfahrenen Entwickler, der deine Firma nie betreten hat, nur einen Satz: „Bau eine Benutzerverwaltung.“ Er wird etwas Vernünftiges bauen — aber eben sein Vernünftiges. Vielleicht mit einem anderen Framework, einem anderen Paketschema, einer eigenen Passwort-Logik statt eurem SSO, englischen Kommentaren in einem deutschsprachigen Team. Nichts davon ist „falsch“ im Sinne von kaputt. Alles davon ist falsch im Sinne von „passt nicht zu uns“. Ein Agent verhält sich genauso, nur schneller und ohne nachzufragen.
Müll rein, Müll raus — in drei Varianten
Bei klassischen Programmen meint „Garbage in, garbage out“ fehlerhafte Eingabedaten. Bei Agenten gibt es drei typische Ausprägungen:
- Fehlender Kontext. Der Agent rät. Er wählt plausible Standards — die nicht deine sind. Das Ergebnis ist in sich stimmig, aber fremd: falscher Stack, falsche Struktur, falsche Sprache.
- Widersprüchlicher Kontext. In der README steht „Java 21“, in der Projektbeschreibung „Java 25“, in einer alten Anleitung „Java 17“. Der Agent entscheidet sich für eine Variante — welche, ist kaum vorhersehbar. Widersprüche sind schlimmer als Lücken, weil sie das Ergebnis zufällig machen.
- Überladener Kontext. Zwanzig Seiten Firmenrichtlinien, alte Protokolle und ganze Wikis „zur Sicherheit“. Das Wichtige geht im Unwichtigen unter, das Kontextbudget ist verbraucht, bevor der Agent die eigentliche Aufgabe angeht, und jede zusätzliche Zeile erhöht die Chance auf Widersprüche.
Guter Kontext ist deshalb nicht viel Kontext, sondern zutreffender, knapper und widerspruchsfreier Kontext. Diese drei Eigenschaften ziehen sich durch das ganze Kapitel.
3.2 Welche Arten von Kontext es gibt
Es hilft, Kontext nicht als einen großen Textblock zu denken, sondern als Schichten mit unterschiedlicher Lebensdauer und unterschiedlichem Zweck. Je stabiler eine Information ist, desto weiter „unten“ gehört sie hin — und desto seltener sollte sie sich ändern.
| Schicht | Frage, die sie beantwortet | Lebensdauer | Beispiel |
|---|---|---|---|
| Projektbeschreibung | Was bauen wir, für wen, warum? | Monate bis Jahre | Vision, Zielgruppe, Domäne, Nicht-Ziele |
| Technische Konventionen | Womit und wie bauen wir? | Monate | Stack, Architekturstil, Paketstruktur, Commit-Konventionen |
| Leitplanken | Wie soll sich der Agent grundsätzlich verhalten? | sehr stabil | „Kleine, chirurgische Änderungen“, „Erfolg prüfbar machen“ |
| Gedächtnis | Was haben wir unterwegs gelernt und entschieden? | wächst laufend | „Wir nutzen Testcontainers statt H2“, „Modul X ist Altlast“ |
| Anforderungen | Was genau muss gelten, damit es fertig ist? | je Feature | Spec mit Akzeptanzkriterien (Kapitel 4) |
| Auftrag | Was soll dieser Lauf tun? | ein Lauf | „Implementiere den Auftrags-CRUD gemäß PROJECT.md“ |
Zwei Beobachtungen dazu. Erstens: Der Auftrag ist die einzige Schicht, die sich bei jedem Lauf ändert. Wer alles in den Auftrag packt, schreibt bei jedem Lauf dieselben Grundlagen neu — und jedes Mal ein bisschen anders. Zweitens: Die Schichten haben eine natürliche Rangfolge. Eine projektspezifische Entscheidung („wir verwenden hier bewusst keine Lombok-Annotationen“) sollte eine allgemeine Leitplanke übersteuern können, nicht umgekehrt. Diese Rangfolge muss irgendwo ausdrücklich stehen, sonst entscheidet der Agent sie selbst.
Konventionen als Kontext
Viele Teams haben Konventionen, die nirgends aufgeschrieben sind: wie Tests heißen, wo DTOs liegen, ob Commit-Nachrichten Deutsch oder Englisch sind, welche Bibliotheken unerwünscht sind. Menschen lernen das durch Code-Reviews und Mitlesen. Ein Agent kann das nur, wenn er genug repräsentativen Bestandscode liest — und selbst dann übernimmt er Fehler der Vergangenheit ebenso bereitwillig wie gute Muster. Aufgeschriebene Konventionen sind deshalb für Agenten wertvoller als für Menschen. Sie sind ein Hebel mit langer Wirkung: einmal sauber formuliert, wirken sie in jedem Lauf.
Gedächtnis als Kontext
Ein Agent startet jeden Lauf bei null. Alles, was in Lauf 1 mühsam herausgefunden wurde — dass ein bestimmter Test flackert, dass ein Modul nicht angefasst werden soll, dass man sich gegen eine Bibliothek entschieden hat — ist in Lauf 2 vergessen, wenn es nicht irgendwo festgehalten wird. Ein gepflegtes Projektgedächtnis ist die Antwort darauf: eine kuratierte, kurze Liste von Entscheidungen und Erkenntnissen, die jedem Folgelauf mitgegeben wird. Kuratiert heißt: Ein Mensch entscheidet, was dauerhaft gilt. Ein Gedächtnis, in das jeder Lauf ungefiltert hineinschreibt, wächst zu genau dem überladenen Kontext, vor dem 3.1 warnt.
In der Fabrik
Der Projekt-Assistent baut die unterste Schicht
In der Fabrik beginnt jedes Vorhaben mit einem Projekt. Es gibt zwei Wege, eines anzulegen:
- Projekt-Assistent unter
/wizard— geführt, empfohlen für den Einstieg. - Schnell anlegen unter
/projects/new— ein knappes Formular mit Titel und Produktname; danach füllst du alles im Editor selbst.
Der Assistent führt in sechs Schritten durch die Anlage und denkt dabei in drei voneinander unabhängigen Dimensionen: Zielplattform × Backend × Frontend(s). Damit lassen sich auch Produkte ausdrücken, die ein Backend und mehrere Clients haben.
| Schritt | Inhalt | Kontext, der dabei entsteht |
|---|---|---|
| 1 – Zielplattform & Projekttyp | Web, Mobile, Desktop (Mehrfachauswahl) oder „bestehendes Repo importieren“ | Wofür wird gebaut? Greenfield oder Bestand? |
| 2 – Backend | z. B. Spring Boot, Quarkus, ASP.NET, FastAPI/Flask, Node — oder „kein Backend“ | Technologie-Grundentscheidung |
| 3 – Frontend(s) | Mehrfachauswahl, gefiltert nach Plattform und Backend | Clients und ihre Stacks |
| 4 – Fragen | Basisdaten und stack-spezifische Felder (z. B. Java-Version, Datenbank, Architekturstil) | Konventionen und Vision |
| 5 – Quality-Gates | optionale Toggles (z. B. ArchUnit, OWASP Dependency-Check, Trivy, ESLint, Playwright); wo freigeschaltet, zusätzlich der Spec-Modus | Was später geprüft wird |
| 6 – Zusammenfassung | Review, lokale Token-/Kostenschätzung, Vorschau des Initial-Prompts | Der erste Auftrag |
Am Ende legt der Assistent ein Projekt im Status Entwurf an und leitet in den normalen Projekt-Editor; dort bleiben alle Felder editierbar. Der Filter in Schritt 3 warnt übrigens nur, wenn eine Zielplattform von keinem Frontend abgedeckt ist — er blockiert nicht. Eine reine API ohne Frontend ist also ausdrücklich möglich.
Der Spec-Modus in Schritt 5 (AUS, LEICHT, STRENG; Voreinstellung AUS) erscheint nur, wenn Spec-Driven Development freigeschaltet ist (Feature-Flag und, bei aktivem Lizenzsystem, Tier Professional oder Enterprise). Was die Modi bewirken, lernst du ausführlich in Kapitel 4.
3.3 Eine gute Projektbeschreibung schreiben
Die Projektbeschreibung ist die Charta des Vorhabens. Sie beantwortet die Fragen, die ein neues Teammitglied in der ersten Woche stellen würde. Für Agenten gelten dabei ein paar Regeln, die über normales „gutes Schreiben“ hinausgehen.
Konkret statt wohlklingend
„Moderne, skalierbare, sichere Architektur“ ist für einen Agenten wertlos — jede Architektur hält sich selbst für modern, skalierbar und sicher. Wertvoll ist: „Hexagonal (Ports & Adapters), Basis-Paket io.beispiel.maint, REST unter /api/v1, keine JPA-Annotationen in der Domäne.“ Faustregel: Wenn ein Satz für jedes beliebige Projekt stimmen würde, trägt er nichts bei.
Versionen und Namen ausschreiben
Agenten kennen viele Versionen eines Frameworks und mischen sie gern. Schreib die Version hin, die du willst, und den Build-Befehl, der grün sein muss. Je näher eine Angabe an etwas Prüfbarem ist, desto zuverlässiger wird sie eingehalten.
Nicht-Ziele benennen
Agenten neigen zu Übererfüllung: Sie fügen „der Vollständigkeit halber“ Features, Konfigurationsoptionen oder Abstraktionen hinzu. Ein Abschnitt, der klar sagt, was nicht gebaut wird („kein Mehrmandantenbetrieb in Version 1“, „keine eigene Benutzerverwaltung, Login nur über OIDC“), ist eine der wirksamsten Maßnahmen gegen Scope-Creep. In Specs ist der Abschnitt „Nicht-Ziele“ deshalb Pflicht (Kapitel 4).
Domänensprache festlegen
Heißt es „Auftrag“, „Ticket“ oder „Job“? „Kunde“ oder „Mandant“? Wenn die Beschreibung die Begriffe festlegt, übernimmt der Agent sie in Klassennamen, Tabellen und Oberflächen. Wenn nicht, erfindet er eigene — und du hast ab dem zweiten Lauf zwei Begriffe für dieselbe Sache.
Sicherheits- und Qualitätsanforderungen gehören dazu
Dass Passwörter nicht im Klartext gespeichert werden, „weiß“ jedes Modell. Dass ihr ausschließlich über OIDC anmeldet, die Rollen ADMIN und DISPONENT habt und WCAG 2.1 AA einhalten müsst, weiß es nicht. Projektspezifische Anforderungen sind genau die, die ohne Aufschreiben verloren gehen.
Schwach:  "Eine sichere, moderne Web-App für Wartungsaufträge."

Stark:    "Web-Portal + REST-API zur Verwaltung von Wartungsaufträgen.
           Disponenten planen im Web; die API bedient später eine Mobile-App.
           Backend Spring Boot / Java 21 / PostgreSQL / Maven, hexagonal,
           Basis-Paket io.beispiel.maint, REST unter /api/v1.
           Login nur OIDC, Rollen ADMIN und DISPONENT.
Nicht in Version 1: Mobile-App, Mehrmandantenbetrieb."In der Fabrik
Die 13 Felder der Projektdefinition
Im Projekt-Editor (/projects/{id}/edit) pflegst du die Projektdefinition. Sie ist das Herzstück, aus dem die Fabrik die Eingabe-Artefakte für den Agenten erzeugt. Neben den Stammdaten Titel und Produktname hat sie 13 inhaltliche Felder:
| Feld | Bedeutung | Worauf du achten solltest |
|---|---|---|
shortDescription | Ein- bis Zweizeiler | Muss das Projekt eindeutig von anderen unterscheiden |
vision | Zielbild | 2–4 Sätze: Was ist am Ende anders als heute? |
targetAudience | Wer nutzt das Produkt | Rollen nennen, die später in Berechtigungen auftauchen |
technologyPreferences | Stack und Versionen | Versionen ausschreiben, Build-Werkzeug nennen |
architecturePreferences | Architekturstil, Schichten, Pakete | Basis-Paket und Schichtregeln konkret angeben |
securityRequirements | Sicherheitsanforderungen | Anmeldeverfahren, Rollen, Datenklassen |
accessibilityRequirements | Barrierefreiheit | Norm und Stufe, z. B. WCAG 2.1 AA |
nonfunctionalRequirements | NFRs, Quality-Gates | Messbare Werte statt Adjektive |
gitWorkflowPreferences | Branching, Commit-Konventionen | z. B. Conventional Commits, trunk-based |
documentationRequirements | gewünschte Doku | README, ADRs, OpenAPI — was genau? |
languagePreference | Sprache für Kommentare und Doku | de oder en |
sectorContext | Branchen- und Domänenkontext | Regulatorik, Fachbegriffe, Datenschutzrelevanz |
freeText | alles Weitere | Hier landet auch der Prompt aus dem Assistenten |
Leere Felder erscheinen im generierten Prompt als offene Platzhalter. Das ist bewusst sichtbar gemacht: Du kannst sie im Editor nachziehen, bevor du den ersten Run startest. Ein leeres Feld ist kein Fehler — aber ein Hinweis, dass der Agent an dieser Stelle raten wird.
3.4 Das Kontextbudget: was hineingehört und was nicht
Jedes Modell hat ein begrenztes Kontextfenster, gemessen in Tokens. Was hineinpasst, ist zwar mit den Modellgenerationen gewachsen, aber zwei Dinge bleiben: Erstens kostet jedes Token Zeit und — je nach Abrechnung — Geld, und zwar in jedem Schritt der Agenten-Schleife erneut, weil der bisherige Verlauf immer wieder mitgeschickt wird (Caching mildert das, siehe Kapitel 10). Zweitens werden Modelle mit sehr langen Kontexten nicht automatisch besser: Informationen in der Mitte langer Texte werden erfahrungsgemäß weniger zuverlässig berücksichtigt als am Anfang oder Ende, und jede zusätzliche Information konkurriert mit der eigentlichen Aufgabe um Aufmerksamkeit.
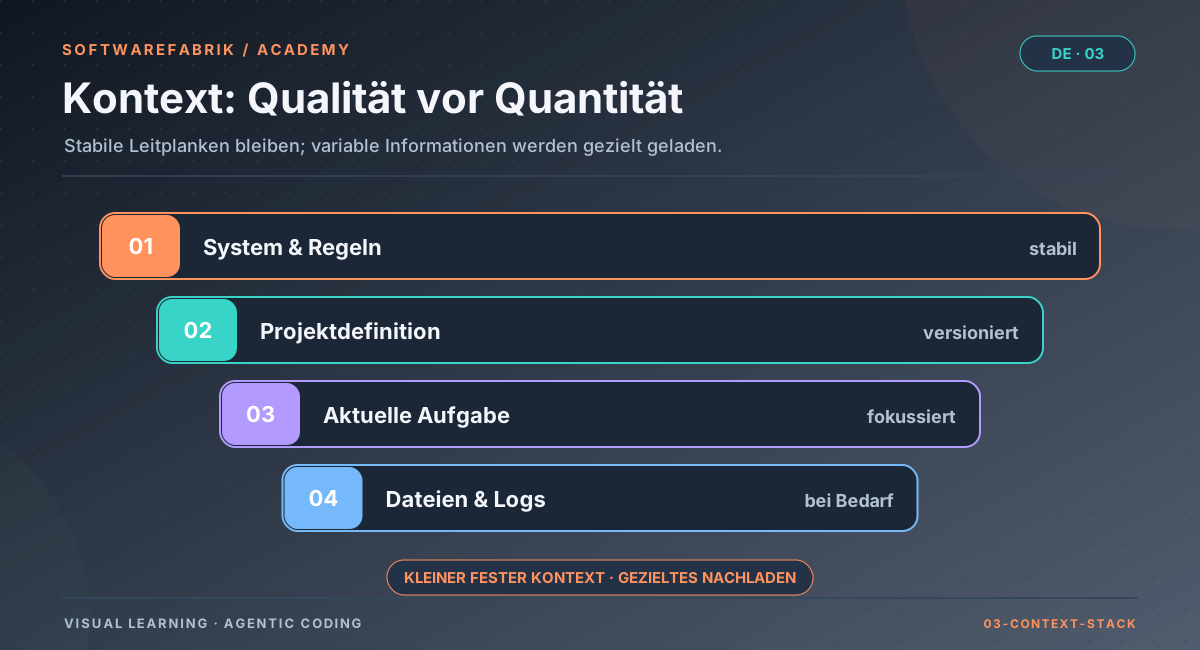
Daraus ergibt sich eine einfache Haushaltsregel: Der feste Kontext, der in jeden Lauf geht, soll klein und hochwertig sein. Der variable Kontext — Bestandscode, Logs, Dokumentation — soll der Agent sich bei Bedarf selbst holen, indem er Dateien liest und sucht.
Gehört in den festen Kontext
- Zielbild und Nicht-Ziele in wenigen Sätzen
- Stack, Versionen, Build- und Testbefehl
- Architekturregeln, die nicht aus dem Code ablesbar sind
- Verhaltensleitplanken (kleine Änderungen, Annahmen offenlegen, Erfolg prüfbar machen)
- kuratierte Entscheidungen aus dem Gedächtnis
- die Akzeptanzkriterien dieses Auftrags — nicht die aller Features
Gehört nicht in den festen Kontext
- ganze Wikis, Protokolle, E-Mail-Verläufe
- Informationen, die im Code stehen und dort gelesen werden können
- veraltete Anleitungen „zur Sicherheit“
- Geheimnisse jeder Art (API-Keys, Passwörter, Tokens) — mehr dazu in Kapitel 8
- Wiederholungen derselben Regel in leicht unterschiedlicher Formulierung
Widersprüche aktiv suchen
Die gefährlichste Form schlechten Kontexts ist der Widerspruch, den niemand bemerkt. Er entsteht fast immer, wenn dieselbe Information an mehreren Stellen gepflegt wird: im Wiki, in der README, in einer Werkzeug-spezifischen Konfigurationsdatei, im Prompt. Die wirksamste Gegenmaßnahme ist strukturell: eine Quelle, mehrere Projektionen. Jede Information wird an genau einer Stelle gepflegt und von dort automatisch dorthin verteilt, wo sie gebraucht wird. Genau dieses Prinzip verfolgt die Fabrik mit ihren Artefakten und Guardrails.
In der Fabrik
Prompt-Artefakte: aus der Definition werden Dateien
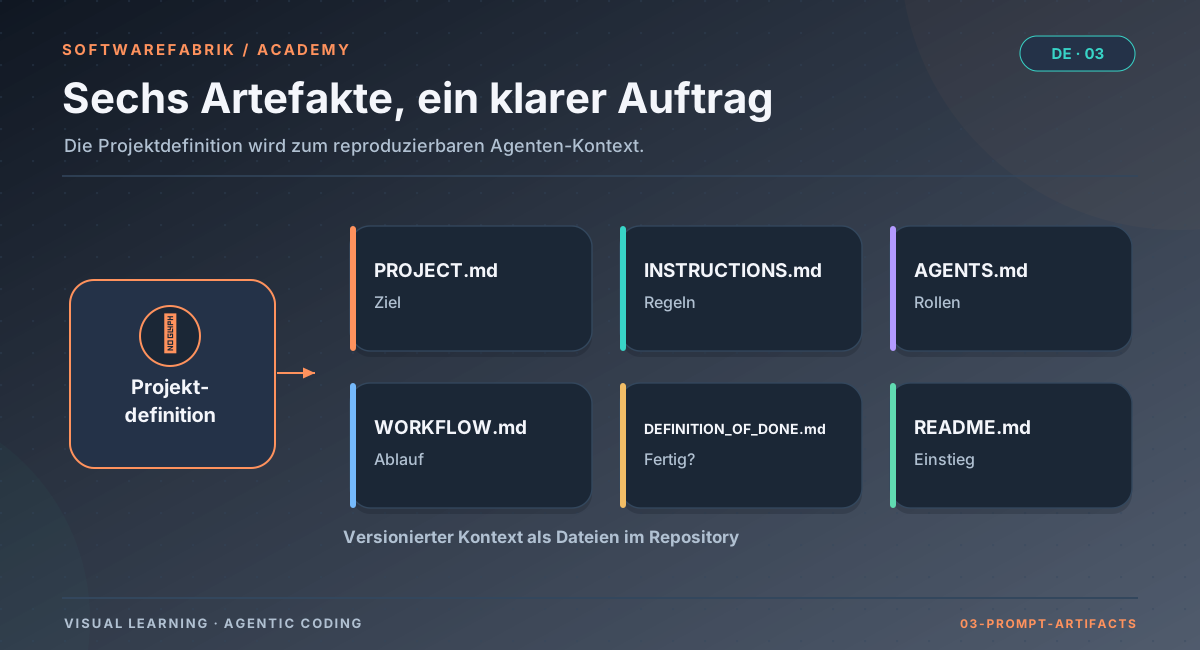
Auf der Projektseite erzeugst du per „Markdown-Artefakte generieren“ aus der Projektdefinition versionierte Markdown-Dateien. Die Übersicht dazu findest du unter /projects/{id}/artifacts, jedes einzelne Artefakt unter /projects/{id}/artifacts/{kind}.
| Artefakt | Inhalt |
|---|---|
PROJECT.md | Die Charta: nummerierte Abschnitte, 1:1 aus den Feldern (Zielbild, Stack, Architektur, Security, NFRs, Git, Doku, Sprache, Sektor, Freitext) |
INSTRUCTIONS.md | Arbeitsweise, Architektur- und Security-Leitplanken, Build/Test, Git-Disziplin, verbotene Abkürzungen |
AGENTS.md | Die aktiven Agentenrollen; bei Runs zusätzlich mit den Engineering-Guardrails als Kopf |
WORKFLOW.md | Phasenmodell und Freigabepunkte |
DEFINITION_OF_DONE.md | Wann ein Run fertig ist: Build und Tests grün (mvn verify, Coverage), dazu die Projektanforderungen zu NFRs, Sicherheit, Barrierefreiheit und Doku |
README.md | Lese-Einstieg in den Workspace |
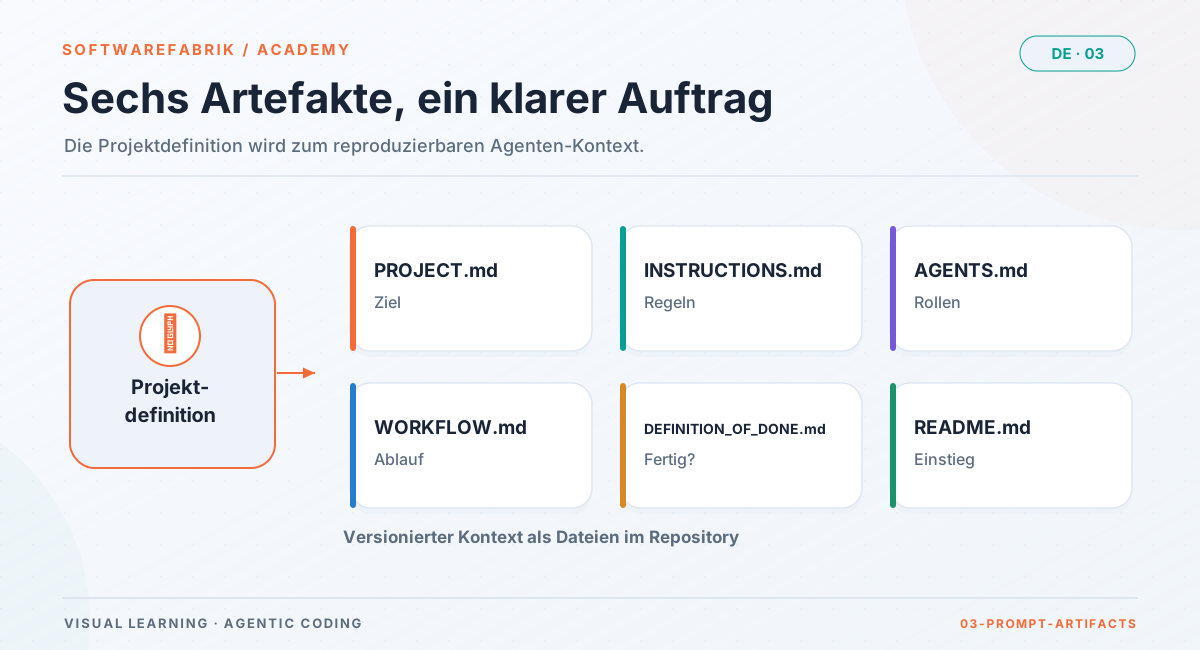
Drei Eigenschaften sind wichtig:
- Versioniert und editierbar. Du kannst jedes Artefakt im Browser anpassen. Jede Änderung erzeugt eine neue Version (nichts wird überschrieben) und einen Audit-Eintrag
PROMPT_EDITED; das Generieren selbst wird alsPROMPTS_GENERATEDfestgehalten. Bearbeiten dürfen Nutzer ab Rolle DEVELOPER. - Im Workspace und im Aufruf. Beim Run werden die Dateien in den Workspace geschrieben und committet.
PROJECT.mdundINSTRUCTIONS.mdgehen zusätzlich direkt in den Agenten-Aufruf. - Nicht destruktiv. Der Workspace gehört dem Projekt, nicht dem Run; die Artefakte werden bei jedem Run aktualisiert, ohne den Code des Agenten anzutasten.
PROJECT.md ist billig zu korrigieren — derselbe Tippfehler, verteilt über zwanzig generierte Klassen, nicht.
Im Datenmodell existiert außerdem der Artefakttyp UX_CONCEPT; der Generator erzeugt ihn in der aktuellen Version aber nicht. Rechne in der Oberfläche also mit den sechs genannten Dateien.
3.5 AGENTS.md: eine Konvention für alle Werkzeuge
Fast jedes Coding-Werkzeug liest beim Start eine Projektdatei mit Hinweisen ein — aber jedes hat historisch seine eigene: Claude Code liest CLAUDE.md, Gemini CLI GEMINI.md, andere Werkzeuge eigene Dateien oder Konfigurationsverzeichnisse. Wer mehrere Werkzeuge einsetzt, pflegt schnell drei Dateien mit fast demselben Inhalt — und hat nach wenigen Wochen drei leicht unterschiedliche Wahrheiten.
AGENTS.md hat sich als werkzeugübergreifende Konvention dafür etabliert: eine schlichte Markdown-Datei im Repository-Wurzelverzeichnis, die beschreibt, wie in diesem Projekt gearbeitet wird — Build- und Testbefehle, Konventionen, Verbote, Hinweise. Viele Werkzeuge lesen sie direkt, andere lassen sich per Konfiguration darauf verweisen oder bekommen eine kleine eigene Datei, die nur auf AGENTS.md zeigt.
Was in eine gute AGENTS.md gehört
- Befehle: wie man baut, testet, formatiert — exakt, kopierbar.
- Struktur: wo was liegt, welche Module tabu sind.
- Konventionen: Benennung, Testmuster, Commit-Format.
- Grenzen: was der Agent nicht tun darf (z. B. bestehende Datenbank-Migrationen ändern).
- Verweise: wo ausführlichere Dokumente liegen, statt sie einzukopieren.
Was nicht hineingehört
Alles, was eine eigene, bessere Heimat hat: Anforderungen gehören in Specs, Entscheidungen mit Begründung in ADRs, Lernerfahrungen in ein Gedächtnis. AGENTS.md ist die Bedienungsanleitung des Repositorys für Agenten, kein Sammelbecken.
3.6 Leitplanken: Verhalten statt Inhalt
Projektbeschreibung und Konventionen sagen dem Agenten, was und womit er bauen soll. Leitplanken (Guardrails) sagen ihm, wie er sich dabei verhalten soll — unabhängig vom Projekt. Typische Fehlverhalten von Coding-Agenten sind erstaunlich konstant über Modelle und Werkzeuge hinweg:
- Stilles Raten: Bei Mehrdeutigkeit wird eine Interpretation gewählt, ohne sie zu nennen.
- Übererfüllung: zusätzliche Features, Abstraktionen „für später“, unnötige Konfigurierbarkeit.
- Kollateralschäden: Nebenbei wird benachbarter Code umformatiert, refaktoriert oder „aufgeräumt“, was Diffs aufbläht und Reviews erschwert.
- Unprüfbarer Erfolg: „Fertig, sollte funktionieren“ — ohne Test, der es belegt.
Gute Leitplanken adressieren genau diese Muster, sind kurz und gelten für jedes Werkzeug gleich. Sie sind Standardverhalten: Ein Projekt darf sie übersteuern, wenn es einen Grund hat. Diese Rangfolge — Projekt vor Leitplanke — muss in den Leitplanken selbst stehen, damit der Agent bei Konflikten nicht abwägen muss.
Ein Detail verdient besondere Aufmerksamkeit: Ein Agent, der autonom läuft, hat niemanden, den er fragen kann. Eine Leitplanke wie „frag nach, wenn etwas unklar ist“ ist für einen Headless-Lauf deshalb sinnlos. Besser ist: „Lege Annahmen offen, wähle bei mehreren Deutungen die konservativste und mach Entscheidungen, die Umfang, Kosten oder Risiko verändern, im Plan und in der PR-Beschreibung unübersehbar.“ Das ist die Idee hinter surface, don't ask.
In der Fabrik
Engineering-Guardrails: eine Quelle, jeder Adapter
Die Fabrik bringt eine vendor-neutrale Verhaltens-Policy mit, die Engineering-Guardrails. Sie fließen bei jedem Run in den Kontext jedes Coding-Agenten — egal ob Claude Code, Codex, Gemini oder ein lokales Modell. Die vier Leitplanken (im Original englisch):
- Think first — surface, don't ask: Annahmen festhalten, bei mehreren Deutungen die konservativste wählen und die Alternativen begründen, folgenreiche Entscheidungen im Plan und in der PR-Beschreibung markieren.
- Simplicity first: minimaler Code, der das Ziel erfüllt; nichts Spekulatives.
- Surgical changes: Jede geänderte Zeile muss auf das Ziel zurückführbar sein; benachbarten Code nicht „verbessern“.
- Make it verifiable: Die Aufgabe vor dem Coden als prüfbare Erfolgskriterien formulieren und den Test oder die Prüfung mitliefern — die Verifikationsschleife selbst ist Sache der Pipeline.
Wie sie in den Run kommen
Die Fabrik verlässt sich nicht darauf, dass ein Werkzeug eine bestimmte Datei automatisch einliest. Stattdessen setzt sie den Guardrails-Text als stabilen Kopf vor das Ziel (Objective) des Runs — das einzige Feld, das alle Adapter verarbeiten. Zusätzlich projiziert sie aus derselben Quelle ins Repository:
AGENTS.md— Guardrails als Kopf über der Rollen-Doku,CLAUDE.md— nur ein minimaler Verweis aufAGENTS.md,.gemini/settings.json— verweist Gemini aufAGENTS.mdals Kontextdatei.
Niemand dupliziert den Inhalt von Hand. Das ist das Prinzip „eine Quelle, mehrere Projektionen“ aus 3.4 in Reinform.
Rangfolge, Schalter, Nachweis
- Präzedenz: Die Guardrails sind Default-Leitplanken. Projektspezifische Vorgaben in
INSTRUCTIONS.mdoderMEMORY.mdhaben bei Konflikt Vorrang; der Guardrails-Kopf sagt das ausdrücklich. - Schalter:
run.guardrails.mode(Voreinstellungon), wirksam mit der Präzedenz Projekt > Benutzer > Global.offschaltet Injektion, Projektion und Attestierung gemeinsam ab. - Nachweis: Die Version der Guardrails ist ein SHA-256-Kurzhash ihres Inhalts. Jeder Run hält sie als
RUN_GUARDRAILS_ANGEWENDETin der signierten Audit-Kette fest; der Warum-Trace des Runs zeigt sie an (mehr in Kapitel 9).
AGENTS.md erhält dann zusätzlich einen markierten Spec-Index (ID, Titel, Status, Pfad). Details in Kapitel 4.
Objective eines Build-Runs (vereinfacht)
---------------------------------------
[1] Engineering-Guardrails          (fest, versioniert, Hash attestiert)
[2] Akzeptanzkriterien AC-…         (nur bei Spec-Bezug)
[3] Ziel dieses Runs                (frei, bis 4000 Zeichen)

Workspace (zusätzlich vom Agenten lesbar)
-----------------------------------------
PROJECT.md  INSTRUCTIONS.md  AGENTS.md  WORKFLOW.md
DEFINITION_OF_DONE.md README.md MEMORY.md specs/… (Code)3.7 Gedächtnis: lernen über Läufe hinweg
Ein Projektgedächtnis schließt die Lücke zwischen zwei Läufen. Es ist kein Protokoll (was ist passiert?), sondern ein Destillat (was gilt seitdem?). Drei Arten von Einträgen haben sich bewährt:
- Entscheidungen: „Wir verwenden Testcontainers mit PostgreSQL statt H2, weil H2 die JSONB-Abfragen nicht unterstützt.“
- Fallstricke: „Der Integrationstest
ImportITbraucht eine freie Portrange; nicht parallelisieren.“ - Grenzen: „Das Paket
legacy.billingwird abgelöst; nur Fehlerbehebungen, keine neuen Features.“
Gute Einträge sind kurz, datiert oder versioniert und enthalten eine Begründung. Ohne Begründung kann niemand — weder Mensch noch Agent — später entscheiden, ob die Regel noch gilt. Und das Gedächtnis braucht Pflege: Veraltete Einträge sind widersprüchlicher Kontext mit Ansage.
Wer schreibt ins Gedächtnis?
Hier gibt es eine echte Abwägung. Lässt du nur Menschen schreiben, bleibt das Gedächtnis sauber, aber es veraltet, weil niemand Zeit hat. Lässt du Agenten frei schreiben, wird es aktuell, aber es wuchert und enthält bald Halbwahrheiten. Ein guter Mittelweg: Agenten dürfen Vorschläge ergänzen, ein Mensch kuratiert regelmäßig — streicht, präzisiert, fasst zusammen.
In der Fabrik
Project-Memory: kuratiert in der Datenbank, gespiegelt als MEMORY.md
Jedes Projekt hat ein Project-Memory, das du in der Oberfläche unter Memory (/projects/{id}/memory) bearbeitest. Der Ablauf:
- Vor jedem Run spiegelt die Fabrik den Inhalt als
MEMORY.mdin den Workspace. - Während des Runs kann der Agent die Datei lesen — und aktualisieren.
- Nach dem Run liest die Fabrik eine vom Agenten aktualisierte
MEMORY.mdzurück in die Datenbank (Rück-Ingest).
Die Datenbank ist die Quelle, die Datei die Projektion. Dadurch ist das Memory adapterunabhängig: Ein Folge-Run mit einem anderen Agenten bekommt dasselbe Gedächtnis, weil es nicht in einer werkzeugspezifischen Konfiguration steckt.
Beachte die Präzedenz aus dem vorigen Kasten: Vorgaben in MEMORY.md gehen den allgemeinen Guardrails vor. Das Memory ist damit auch der richtige Ort für bewusste Ausnahmen („In diesem Projekt bitte bestehende Tests nicht umbenennen, auch wenn sie unglücklich heißen“).
3.8 Rollen und Teams als Kontext
„Du bist ein erfahrener Security-Reviewer“ ist mehr als eine Höflichkeitsformel. Eine Rolle bündelt Erwartungen: worauf geachtet wird, was erlaubt ist, wann eskaliert wird. Für Menschen ist das selbstverständlich — ein Reviewer schreibt keinen Feature-Code, ein Architekt plant, bevor gebaut wird. Für Agenten muss es ausdrücklich gesagt werden.
Rollen als Kontext haben zwei Vorteile. Erstens werden Verantwortungen getrennt: Wer schreibt, gibt seine Arbeit nicht selbst frei. Zweitens werden Regeln wiederverwendbar: Die Sicherheitsregeln eines Security-Reviewers schreibst du einmal, nicht in jeden Auftrag neu.
Eine wichtige Einschränkung: Eine Rolle im Prompt ist eine Bitte, keine technische Grenze. Ob ein Reviewer wirklich nichts schreiben kann, entscheiden die Werkzeugrechte, mit denen er gestartet wird, nicht seine Rollenbeschreibung. Rollen und Rechte gehören zusammen — das vertiefen Kapitel 6 (read-only Reviewer) und Kapitel 8 (Permissions).
In der Fabrik
Agentenrollen, Teams und die Skill-Bibliothek
Die Fabrik modelliert Agenten nicht als Promptfragmente, sondern als konfigurierte Rollen. Unter /agents werden Agentendefinitionen verwaltet, unter /teams daraus Teams zusammengestellt. Beide sind globale Bausteine und nur für die Rolle ADMIN bearbeitbar; beim Anlegen eines Runs wählst du ein vorhandenes Team aus.
Rollentypen
Felder einer Agentendefinition
Name, Rolle, Kurzbeschreibung, Mission, Standardinstruktionen, Qualitätsregeln, Security-Regeln, Build-Regeln, Git-Regeln, Sprachpräferenz, erlaubte Werkzeuge, Grenzen, Eskalationshinweise, ein optionales Wunschmodell (preferredModel) und ein Aktiv-Status. Aus den aktiven Agenten erzeugt die Fabrik die Rollen-Doku in AGENTS.md.
Teams im Run
Beim Anlegen eines Runs (/runs/new) wählst du neben Adapter und Ziel ein Team. Das Team beeinflusst unter anderem die Modellwahl: Ist kein Routing-Override gesetzt, gilt das Wunschmodell des Developer-Agenten im Team (sonst das des ersten Agenten mit Modell), danach der Rollen-Default. Die tatsächliche Auflösung wird als RUN_MODELL_AUFGELOEST mit ihrer Quelle attestiert — Einzelheiten in Kapitel 10.
Skill- und Plugin-Bibliothek
Unter /skills (nur ADMIN) werden versionierte, mandanten-gescopte Skills und Plugins (Herkunft CATALOG, INSTALLED oder FORKED). Vor jedem Run materialisiert die Fabrik sie in den Workspace:
<workspace>/.claude/skills/<name>/SKILL.md
<workspace>/.claude/agents/<rolle>.md
<workspace>/.claude/settings.local.jsonDamit ist später beantwortbar, welche Erweiterung in welcher Version zum Zeitpunkt eines Laufs im Kontext des Agenten war — die Frage, an der Reproduzierbarkeitsdiskussionen sonst scheitern. Die Engineering-Guardrails sind davon bewusst getrennt: Sie sind keine optionale Erweiterung, sondern die Grundhaltung jedes Laufs.
3.9 Zusammenfassung
- Ein Agent weiß über dein Projekt nur, was in seinem Kontext liegt. Fehlender, widersprüchlicher und überladener Kontext sind die drei Formen von „Müll rein, Müll raus“.
- Denk Kontext in Schichten: Projektbeschreibung, Konventionen, Leitplanken, Gedächtnis, Anforderungen, Auftrag. Stabile Information gehört nach unten, nur der Auftrag ändert sich je Lauf.
- Der feste Kontext soll klein und hochwertig sein; variablen Kontext holt sich der Agent selbst.
- „Eine Quelle, mehrere Projektionen“ verhindert Widersprüche:
AGENTS.mdals werkzeugübergreifende Datei, aus einer gepflegten Quelle erzeugt. - In der Fabrik entsteht der Kontext aus Projektdefinition (13 Felder), Prompt-Artefakten, Engineering-Guardrails im Objective-Kopf, Project-Memory und Teams — versioniert, editierbar und attestiert.
Übung
Übung: Vom Einzeiler zur belastbaren Projektdefinition
Ausgangslage: Deine Fachabteilung schickt dir folgenden Auftrag: „Wir brauchen eine kleine App, mit der Mitarbeitende Räume buchen können. Sollte modern und sicher sein.“
- Lücken finden: Schreib zu jedem der 13 Felder der Projektdefinition auf, was du aus dem Auftrag ableiten kannst und was du raten müsstest. Markiere die geratenen Felder.
- Annahmen offenlegen: Formuliere für jedes geratene Feld eine ausdrückliche Annahme (z. B. „Annahme: Login über bestehendes OIDC, Rollen MITARBEITER und ADMIN“) und eine Rückfrage an die Fachabteilung.
- Nicht-Ziele: Schreib mindestens drei Nicht-Ziele für Version 1 auf.
- Gedächtnis vorbereiten: Formuliere zwei Einträge, die du nach dem ersten Lauf vermutlich ins Project-Memory schreiben würdest — jeweils mit Begründung.
- In der Fabrik (optional, kostenlos): Stell den Adapter auf
mock, lege das Projekt mit dem Assistenten unter/wizardan, übertrage deine Felder im Editor, generiere die Artefakte und liesPROJECT.mdundINSTRUCTIONS.mdunter/projects/{id}/artifacts. Finde mindestens eine Stelle, an der der generierte Text noch einen Platzhalter enthält, und schließe die Lücke.
Kapitelfragen
-
Nenne die drei Formen von „Müll rein, Müll raus“ bei Agenten und erkläre, warum widersprüchlicher Kontext oft schlimmer ist als fehlender.
Musterantwort
Fehlender Kontext (der Agent rät plausible, aber fremde Standards), widersprüchlicher Kontext (mehrere Quellen sagen Verschiedenes) und überladener Kontext (das Wichtige geht unter, Budget wird verbraucht). Widersprüche sind tückischer, weil das Ergebnis zufällig wird: Welche Variante der Agent wählt, ist kaum vorhersehbar und kann von Lauf zu Lauf wechseln. Eine Lücke führt wenigstens reproduzierbar zum selben Standardverhalten und fällt eher auf.
-
Warum sollte der feste Kontext eines Laufs klein sein, obwohl moderne Modelle sehr große Kontextfenster haben?
Musterantwort
Jedes Token kostet Zeit und gegebenenfalls Geld, und zwar in jedem Schritt der Agenten-Schleife erneut. Außerdem konkurriert jede zusätzliche Information mit der Aufgabe um Aufmerksamkeit; Informationen in langen Texten werden nicht gleichmäßig zuverlässig berücksichtigt. Mehr Text erhöht zudem die Wahrscheinlichkeit für Widersprüche. Variablen Kontext wie Bestandscode holt sich der Agent ohnehin selbst.
-
Was bedeutet das Prinzip „eine Quelle, mehrere Projektionen“, und wie setzt die Fabrik es bei den Engineering-Guardrails um?
Musterantwort
Jede Information wird an genau einer Stelle gepflegt und automatisch dorthin verteilt, wo sie gebraucht wird, statt mehrere Kopien zu pflegen. Die Guardrails liegen als eine versionierte Quelle vor; die Fabrik setzt sie als Kopf vor das Objective jedes Runs (für alle Adapter) und projiziert daraus
AGENTS.md, eine minimaleCLAUDE.mdmit Verweis und.gemini/settings.json, das aufAGENTS.mdzeigt. Niemand kopiert den Text von Hand. -
Warum verlässt sich die Fabrik nicht darauf, dass ein Coding-Werkzeug
AGENTS.mdoderCLAUDE.mdselbst einliest?Musterantwort
Die Autoload-Logik unterscheidet sich je Werkzeug und Version (Dateinamen, Größengrenzen, Konfiguration). Wer sich darauf verlässt, hat einen stillen Fehlerpunkt. Das Objective ist das einzige Feld, das alle Adapter verarbeiten; dort eingesetzter Kontext erreicht deterministisch jeden Agenten. Die Dateien im Repository sind zusätzlich da, damit Agent und Mensch dieselbe Grundlage lesen können.
-
In
INSTRUCTIONS.mdsteht „Kommentare auf Englisch“, die Guardrails enthalten keine Sprachregel, im Memory steht „Kommentare auf Deutsch, Entscheidung vom März“. Was passiert, und was solltest du tun?Musterantwort
Projektvorgaben in
INSTRUCTIONS.mdundMEMORY.mdgehen beide den Guardrails vor, aber untereinander widersprechen sie sich — der Agent muss raten. Das ist genau der widersprüchliche Kontext aus 3.1. Du solltest die Quelle bereinigen: Wenn die Märzentscheidung gilt, das FeldlanguagePreferencein der Projektdefinition aufdesetzen, Artefakte neu generieren bzw.INSTRUCTIONS.mdkorrigieren und den Memory-Eintrag behalten oder streichen, damit es nur noch eine Aussage gibt. -
Wie funktioniert das Project-Memory technisch, und warum ist es adapterunabhängig?
Musterantwort
Das Memory liegt in der Datenbank und wird unter Memory (
/projects/{id}/memory) gepflegt. Vor jedem Run spiegelt die Fabrik es alsMEMORY.mdin den Workspace; nach dem Run liest sie eine vom Agenten aktualisierte Datei zurück. Weil die Quelle die Datenbank ist und nicht eine werkzeugspezifische Konfiguration, bekommt jeder Adapter dasselbe Gedächtnis — auch nach einem Adapterwechsel. -
Ein Kollege schlägt vor, das komplette Team-Wiki (300 Seiten) als
freeTextin die Projektdefinition zu kopieren, „damit der Agent alles weiß“. Wie argumentierst du?Musterantwort
Das erzeugt überladenen Kontext: hohes Tokenvolumen in jedem Lauf, wichtige Regeln gehen unter, veraltete Seiten erzeugen Widersprüche. Besser: die wenigen projektrelevanten, stabilen Regeln destillieren und in die passenden Felder schreiben (Architektur, Security, NFRs), Entscheidungen ins Memory, Anforderungen in Specs. Auf ausführliche Dokumente im Repository verweisen, damit der Agent sie bei Bedarf liest.
-
Warum ist eine Rolle wie „Reviewer“ im Prompt allein keine Sicherheitsgarantie, und was gehört ergänzend dazu?
Musterantwort
Die Rollenbeschreibung ist eine Bitte an das Modell, keine technische Grenze. Ob ein Reviewer schreiben kann, entscheiden die Werkzeugrechte, mit denen er gestartet wird. In der Fabrik laufen Reviewer deshalb technisch read-only (eingeschränkte Werkzeugrechte, kein Schreiben in den Workspace). Rolle und Rechte gehören zusammen.
-
Du übernimmst ein bestehendes Projekt in die Fabrik, in dessen Repository bereits eine handgepflegte
CLAUDE.mdmit wichtigen Konventionen liegt. Wie gehst du vor, damit diese Konventionen künftig in jedem Lauf wirken — auch mit anderen Adaptern?Musterantwort
Die Fabrik projiziert bei aktivierten Guardrails eine eigene minimale
CLAUDE.md, die aufAGENTS.mdverweist; eine nur dort gepflegte Konvention ist also keine verlässliche Quelle mehr und wäre ohnehin Claude-spezifisch. Die Inhalte gehören in die werkzeugneutralen Quellen der Fabrik: dauerhafte technische Konventionen in die Projektdefinition (Architektur, Git, Doku), daraus generiert inINSTRUCTIONS.md/PROJECT.md; gelernte Entscheidungen ins Project-Memory. Danach wirken sie für jeden Adapter, und Projektvorgaben gehen den allgemeinen Guardrails vor.