Lernziele
Nach diesem Kapitel kannst du:
- Modelle nach Aufgabe wählen: begründen, warum Planen, Bauen und Prüfen unterschiedliche Modellklassen verdienen.
- Tokens verstehen: Input-, Output- und Cache-Tokens unterscheiden und abschätzen, wo in einem Agentenlauf die Kosten entstehen.
- Kostenhebel anwenden: Kontext klein halten, Wiederholungen vermeiden, die richtige Modellklasse wählen.
- Die Modellwahl der Fabrik nachvollziehen: die Rangfolge Override → Team → Rollen-Default → CLI-Wahl erklären und im Warum-Trace wiederfinden.
- Kosten richtig lesen: abgerechnete Kosten von Schätzungen im Abo-Modus unterscheiden.
- Grenzen setzen: Budgets, Hard-Caps und Token-Limits gezielt einsetzen.
- Betrieb einordnen: Mandanten, Rollen, SSO, Betriebsmodi, Lizenz-Tiers und Betriebsformen auseinanderhalten.
10.1 Ein Modell ist kein Modell: Wahl nach Aufgabe
In den ersten Kapiteln hast du gelernt, dass ein Coding-Agent aus einem Sprachmodell, Werkzeugen und einer Schleife besteht. Das Sprachmodell ist dabei die austauschbarste und zugleich teuerste Komponente. Anbieter bieten fast immer mehrere Modellklassen an: große, langsame, teure Modelle mit viel Urteilsvermögen; mittlere Modelle als Arbeitspferde; kleine, schnelle, günstige Modelle für einfache, gut umrissene Aufgaben. Die Namen, Versionen und Preise ändern sich im Monatsrhythmus. Das Prinzip dahinter bleibt stabil.
Das Prinzip lautet: Nicht jede Aufgabe braucht das stärkste Modell. Im Softwarealltag mit Agenten lassen sich drei Aufgabentypen unterscheiden, die sehr unterschiedliche Anforderungen stellen.
Planen
Beim Planen zerlegt der Agent ein Ziel in Arbeitspakete, wägt Architekturvarianten ab, erkennt Abhängigkeiten und Risiken. Fehler in dieser Phase sind teuer, weil sie sich durch alle nachfolgenden Schritte ziehen: Ein falscher Schnitt erzeugt zehn falsche Build-Läufe. Gleichzeitig ist die Ausgabe eines Planungslaufs vergleichsweise kurz — ein paar Markdown-Dateien statt hunderter Zeilen Code. Hier lohnt sich ein starkes Modell: Die Mehrkosten pro Token treffen auf wenige Tokens und vermeiden teure Folgefehler.
Bauen
Beim Bauen setzt der Agent einen gut umrissenen Plan um: Dateien anlegen, Code schreiben, Tests ergänzen, Build ausführen, Fehler beheben. Diese Arbeit ist umfangreich, aber meist mechanischer. Ein solides mittleres Modell schafft sie in der Regel zuverlässig, wenn der Auftrag präzise ist — und genau dafür sorgen Spec und Plan aus den Kapiteln 4 und 5. Hier entsteht der Großteil des Token-Volumens; die Modellklasse wirkt sich daher stark auf die Gesamtkosten aus.
Prüfen
Beim Prüfen liest ein Reviewer einen Diff und meldet Befunde. Reviews sind häufig, laufen oft parallel und arbeiten mit begrenztem Kontext. Ein kleines, schnelles Modell ist hier oft ausreichend, zumal ein guter Prüfprozess ohnehin nicht nur auf ein LLM setzt, sondern regelbasierte Prüfungen (Tests, statische Analyse, Abdeckungsprüfung) danebenstellt. Wo ein Review sehr anspruchsvoll ist — etwa eine Sicherheitsbewertung — kann ein stärkeres Modell sinnvoll sein.
Modellwahl ist eine Konfigurationsfrage, keine Code-Frage
Weil Modelle schnell veralten, sollte kein Modellname fest in Werkzeugen, Skripten oder Prompts verdrahtet sein. Wer die Modellwahl zentral konfiguriert, kann bei einem neuen Modell an einer Stelle umstellen — und weiß hinterher, welcher Lauf mit welchem Modell entstanden ist. Diese Nachvollziehbarkeit ist nicht nur Ordnungsliebe: Wenn ein Ergebnis auffällt, ist „welches Modell war das?“ eine der ersten Fragen.
In der Fabrik
Rangfolge der Modellwahl und Capability-Routing
Die Fabrik trennt die Modellwahl für Planung und Umsetzung über das sogenannte Capability-Routing: Die Einstellungen run.routing.plan-model und run.routing.build-model legen fest, welches Modell Plan-Runs und welches Build-Runs bekommen. So kann Planung ein stärkeres Modell erhalten als mechanische Umsetzung, ohne dass irgendwo ein Modellname hart verdrahtet ist.
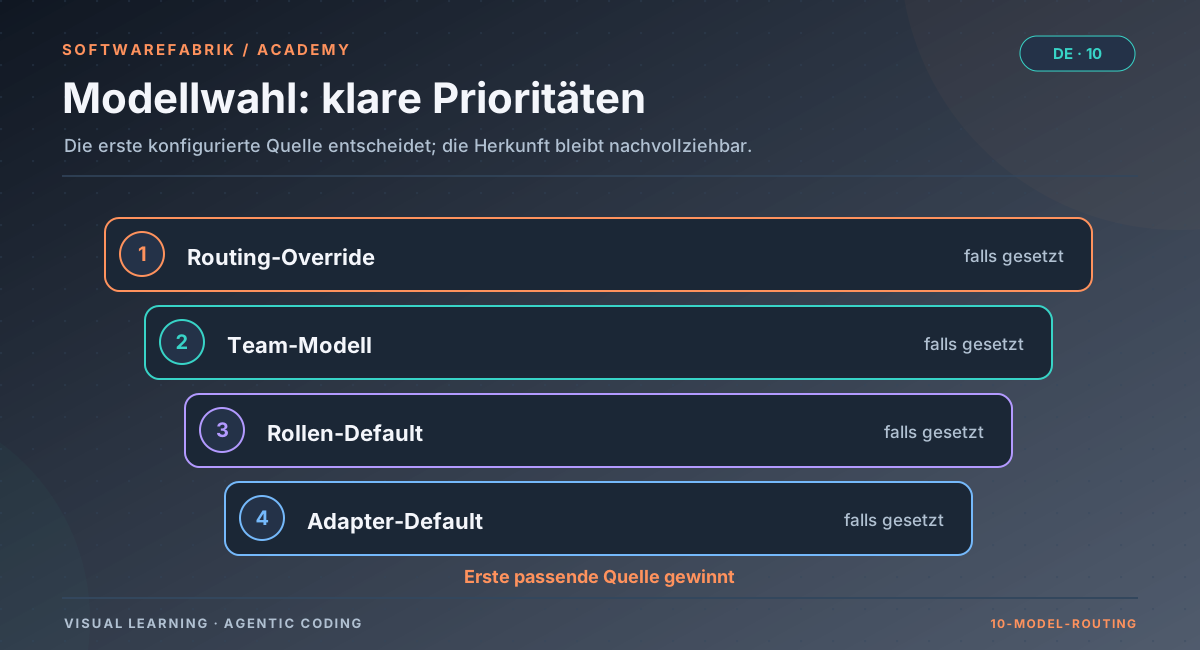
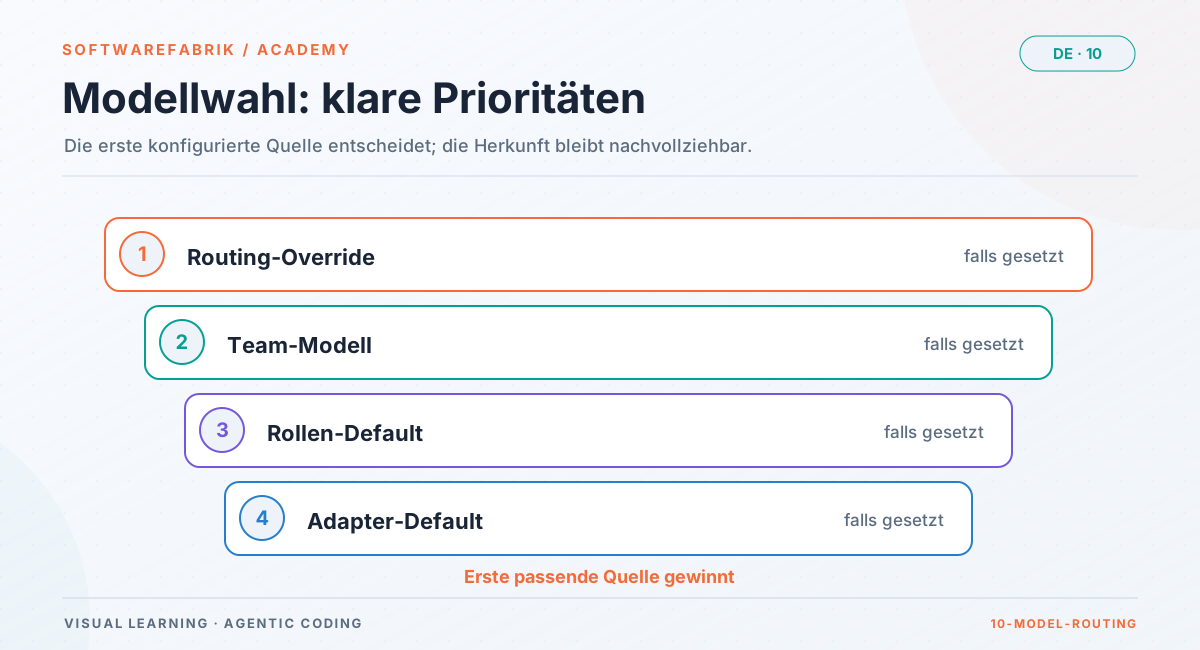
Für jeden Run löst die Fabrik das Modell in einer festen Rangfolge auf:
| Rang | Quelle | Woher der Wert kommt |
|---|---|---|
| 1 | override | Routing-Override run.routing.plan-model bzw. run.routing.build-model |
| 2 | team | Wunschmodell des Teams: preferredModel des Developer-Agenten, sonst des ersten Agenten mit Modell |
| 3 | rollen-default | Rollen-Default aus der Preistabelle — nur für den Adapter claude |
| 4 | adapter-default | Kein --model-Flag; die CLI wählt selbst |
Die Rollen-Defaults für Claude Code sind laut Administrationshandbuch (Stand v0.38.0): Plan → Opus (claude-opus-5-5), Build → Sonnet (claude-sonnet-5-5); Reviews laufen per Default mit Haiku (claude-haiku-5-5, einstellbar über softwarefabrik.review.claudecode.model; leer heißt: kein --model-Flag). Fable (claude-fable-5-1) ist wegen des Preises nie Default und nur über Team-Einstellung oder Override wählbar. Die konkreten IDs ändern sich mit neuen Modellgenerationen — maßgeblich ist immer das Administrationshandbuch der installierten Version.
Andere Adapter (Aider, Bedrock/Vertex/Azure, Local-LLM, Kimi) erhalten den Claude-Rollen-Default bewusst nicht, weil sie --model unverändert an ihre eigene CLI durchreichen. Für Codex, Kimi, Gemini und Aider gibt es stattdessen das Standardmodell je Adapter unter execution.<adapter>.model. Für Claude Code gibt es dieses Setting nicht — seit v0.33.0 kommt das Modell aus Routing, Team oder Rollen-Default.
Nachvollziehbar im Warum-Trace
Jede Auflösung wird als RUN_MODELL_AUFGELOEST in die signierte Audit-Kette geschrieben, mit dem Feld quelle=override|team|rollen-default|adapter-default. Auf der Seite /runs/{id}/trace siehst du also nicht nur, welches Modell gelaufen ist, sondern auch, warum genau dieses: ob jemand es per Override erzwungen hat, ob es aus dem Team kam oder ob der Rollen-Default gegriffen hat.
So stellst du es ein
- Team-Ebene (nur ADMIN): Unter
/agentsöffnest du eine Agentendefinition (z. B. den Developer) und trägst ein bevorzugtes Modell ein. Über/teamsstellst du das Team zusammen, das du beim Run wählst. - Routing-Ebene: Unter Einstellungen setzt du
run.routing.plan-modelund/oderrun.routing.build-model, wenn du für alle Runs (oder per Scope für ein Projekt) eine feste Wahl erzwingen willst. - Prüfen: Nach dem Lauf im Warum-Trace nachsehen, welche
quellegegriffen hat.
10.2 Tokens: die Währung der Agenten
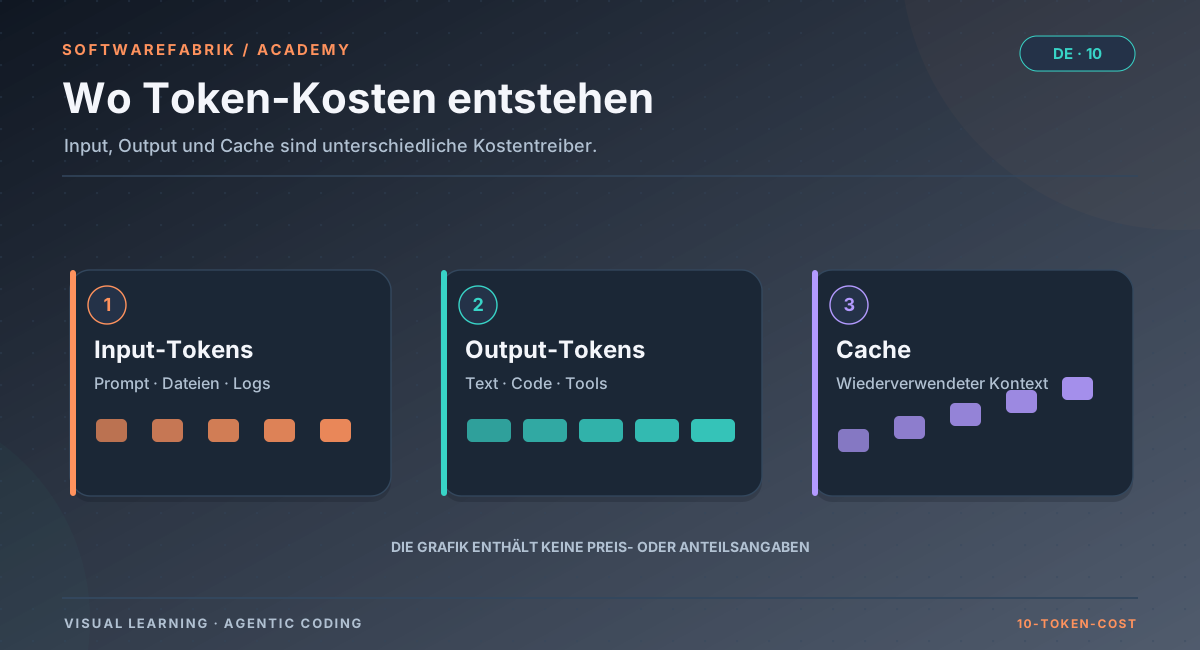
Sprachmodelle rechnen in Tokens. Ein Token ist ein Textbaustein — grob ein Wortteil; im Deutschen entfallen auf ein Wort oft mehr Tokens als im Englischen, und Quellcode mit vielen Sonderzeichen ist ebenfalls tokenreich. Abgerechnet wird bei API-Nutzung typischerweise getrennt nach drei Arten:
| Token-Art | Was es ist | Typischer Anteil in Agentenläufen |
|---|---|---|
| Input | Alles, was das Modell liest: Systemanweisung, Projektkontext, Werkzeugdefinitionen, bisheriger Verlauf, Dateiinhalte, Werkzeugergebnisse | Sehr hoch — jede Runde der Agenten-Schleife schickt den wachsenden Verlauf erneut |
| Output | Was das Modell erzeugt: Text, Code, Werkzeugaufrufe | Deutlich kleiner, aber pro Token meist teurer als Input |
| Cache | Wiederverwendete Eingabeanteile (Lesen aus dem Cache) bzw. das erstmalige Ablegen im Cache (Schreiben) | Bei langen, gleichbleibenden Präfixen oft der Großteil des Inputs |
Warum Agentenläufe so viel Input verbrauchen
Erinnere dich an die Agenten-Schleife aus Kapitel 2: Das Modell denkt, ruft ein Werkzeug auf, bekommt das Ergebnis, denkt weiter. Bei jeder Runde wird der gesamte bisherige Kontext erneut verarbeitet — die Anweisungen, der Projektkontext, alle bisherigen Werkzeugaufrufe und ihre Ergebnisse. Ein Lauf mit vierzig Werkzeugaufrufen verarbeitet den Anfang des Kontexts also rund vierzigmal. Liest der Agent dabei eine große Logdatei oder einen langen Testreport ein, wandert dieser Text in alle folgenden Runden mit.
Daraus folgt eine wichtige Einsicht: Die Kosten eines Agentenlaufs wachsen nicht linear mit der Aufgabengröße, sondern eher mit der Zahl der Runden mal der Kontextgröße. Ein unklarer Auftrag, der den Agenten zum Suchen und Ausprobieren zwingt, ist deshalb doppelt teuer: mehr Runden und mehr Kontext.
Prompt-Caching
Viele Anbieter bieten Prompt-Caching an: Ein gleichbleibender Anfang des Kontexts (Präfix) wird beim ersten Mal gespeichert und bei folgenden Anfragen günstiger wiederverwendet. Das passt gut zu Agenten, weil Anweisungen, Werkzeugdefinitionen und Projektkontext von Runde zu Runde identisch bleiben. Die Details unterscheiden sich je Anbieter (Lebensdauer des Caches, Mindestgröße, Preisaufschlag für das Schreiben, Rabatt für das Lesen); allgemein gilt:
- Das Schreiben in den Cache kostet in der Regel etwas mehr als normaler Input, das Lesen deutlich weniger.
- Caching wirkt nur auf einen stabilen Präfix. Wer an den Anfang des Kontexts ständig wechselnde Inhalte stellt (Zeitstempel, zufällige Reihenfolgen), verhindert Cache-Treffer.
- Agent-CLIs nutzen Caching meist automatisch. Du beeinflusst es vor allem indirekt: durch stabile Projektdateien und Anweisungen.
Abo statt Token-Rechnung
Neben der API-Abrechnung pro Token bieten Anbieter von Coding-Agenten auch Abonnements an, bei denen Läufe gegen Nutzungslimits zählen statt gegen eine Rechnung. Die Bedingungen ändern sich häufig und sind an die Nutzungsbedingungen des jeweiligen Anbieters gebunden — insbesondere, für wen und wofür ein persönliches Abo gedacht ist. Für die Fabrik ist der aktuelle Stand im Benutzerhandbuch und auf der Seite Abo-Setup beschrieben.
In der Fabrik
Kosten erfassen, ausweisen und richtig lesen
Die Fabrik erfasst je Run die Tokens, die der Adapter meldet, und bewertet sie mit einer Modell-Preistabelle. Diese liegt in application.yml unter softwarefabrik.models mit Input-, Output- und Cached-Preisen je eine Million Tokens. Die Prüfung gegen die offiziellen Preisseiten ist fester Punkt der Release-Routine; die Euro-Werte entstehen über einen festen Näherungsfaktor, nicht über einen Tageskurs.
Was in die Bewertung einfließt
- Input-, Output- und Cache-Lese-Tokens je Modell.
- Cache-Schreib-Tokens (seit v0.34.0 erfasst): Sie sind nicht in den Input-Tokens enthalten und werden mit dem 1,25-fachen Input-Preis bewertet.
- Die Kostenschätzung der CLI selbst wird als Gegenprobe im Warum-Trace angezeigt — sie ist keine Abrechnung.
- Laufen in einem Claude-Lauf mehrere Modelle (etwa Subagenten), zählen die Tokens aller Modelle; als bekannte Grenze gilt dabei der Preis des teuersten Modells für alle Tokens.
Drei Sonderfälle, die du kennen musst
| Fall | Ausweis | Bedeutung |
|---|---|---|
| Unbekanntes Modell (kein Eintrag in der Preistabelle) | 0 € | Bewusst konservativ: lieber kein Wert als ein erfundener. Ein 0-€-Lauf mit vielen Tokens ist ein Hinweis, die Tabelle zu prüfen. |
Flatrate-Modelle (k3, kimi-for-coding) | 0 € | Bei Flatrate entstehen keine Token-Kosten; die Sicht zeigt Grenzkosten, nicht Lizenzkosten. |
| Claude-Abo-Modus | Euro-Wert mit Kennzeichnung | Wie API-Läufe bewertet, aber als „Schätzung (API-Tarif), nicht abgerechnet“ gekennzeichnet. |
Der letzte Punkt ist der wichtigste Lesehinweis: Im Claude-Abo-Modus zählen die Läufe gegen die Nutzungslimits deines Abos; eine separate API-Rechnung entsteht nicht. Die Euro-Werte, die die Fabrik trotzdem ausweist, bilden die erzeugte Last zum API-Tarif ab. Sie zählen weiterhin im Verbrauch und damit gegen Budget und Hard-Cap.
Die Kostensichten
| Route | Inhalt |
|---|---|
/analytics | Kosten je Projekt, Run, Provider und im Vergleich, jeweils als CSV |
/mandanten/kosten | Verbrauch je Mandant (auch als .csv), mit Spalte „davon Schätzung (EUR)“ |
/mandanten/seat-kosten | Verbrauch je Seat, also je auslösendem Nutzer (abgeleitet aus run.triggered_by, auch als .csv) |
/runs/{id}/trace | Kosten eines einzelnen Runs neben Modell, Policy, Freigaben und Gate-Ergebnis |
In den CSV-Exporten heißt die Schätzungsspalte Davon-Schaetzung-Abo-EUR. Läufe ohne Auth-Kennzeichen (z. B. mit dem mock-Adapter) und Läufe aus Versionen vor der Kennzeichnung tragen keine Markierung. Auf dem Dashboard siehst du zusätzlich den Token-Verbrauch und die Kosten der letzten 14 Tage.
10.3 Kostenhebel: was wirklich spart
Wer Agentenkosten senken will, denkt oft zuerst an ein günstigeres Modell. Das ist ein Hebel, aber selten der größte. Die wirksamsten Hebel setzen früher an.
Hebel 1: Präzise Aufträge
Ein präzises Ziel mit klaren Akzeptanzkriterien reduziert die Zahl der Runden drastisch. Der Agent muss weniger suchen, weniger raten und weniger nachbessern. Hier zahlt sich die Arbeit aus Kapitel 4 (Specs und EARS) und Kapitel 5 (Planen) direkt in Tokens aus: Ein Build-Run gegen ein gut geschnittenes Backlog-Item mit gebundenen Akzeptanzkriterien ist kürzer als ein Run mit dem Ziel „mach die Auftragsverwaltung fertig“.
Hebel 2: Kontext klein und stabil halten
- Klein: Nur das in den Kontext, was der Auftrag braucht. Riesige Logausgaben, generierte Dateien oder Abhängigkeitsverzeichnisse sind teurer Ballast.
- Stabil: Projektdateien, Anweisungen und Guardrails sollten sich nicht bei jedem Lauf ändern. Das hilft dem Caching und macht Ergebnisse vergleichbarer.
- Kuratiert: Ein gepflegtes Projektgedächtnis mit den wichtigsten Entscheidungen ist besser als ein wachsender Haufen ungefilterter Notizen.
Hebel 3: Die richtige Modellklasse
Wie in 10.1 beschrieben: starkes Modell für Planung, Arbeitspferd für den Bau, kleines Modell für Reviews. Wichtig ist, die Wahl zu messen, nicht zu raten. Wenn ein günstigeres Build-Modell doppelt so viele Korrekturschleifen braucht, ist es am Ende nicht günstiger.
Hebel 4: Keine blinden Wiederholungen
Ein fehlgeschlagener Lauf, der unverändert noch einmal gestartet wird, kostet dasselbe noch einmal — mit ähnlicher Erfolgsaussicht. Eine Wiederholung lohnt sich nur, wenn eine neue Information hinzukommt: Compiler-Ausgabe, Testfehler, Reviewer-Befund, Merge-Konflikt, eine geänderte Anweisung. Genau dieses Prinzip setzt die Fabrik bei ihrer Korrekturschleife um (Kapitel 6): Sie speist das Build- oder Gate-Feedback in den erneuten Lauf ein und begrenzt die Versuche.
Hebel 5: Kleine Schritte
Ein großer Lauf, der nach einer Stunde an einer Kleinigkeit scheitert, verbrennt viel. Mehrere kleine Läufe mit je einem prüfbaren Ergebnis scheitern billiger und lassen sich gezielter korrigieren. Das ist dieselbe Logik wie bei kleinen Pull Requests — nur dass hier zusätzlich Geld am Spiel ist.
In der Fabrik
Budgets, Token-Limits und Kapazitätsschutz
Die Fabrik bietet mehrere Ebenen, um Verbrauch zu begrenzen. Sie ergänzen sich:
| Mechanismus | Ebene | Wirkung |
|---|---|---|
mandant_budget | Mandant, monatlich in EUR | Wahlweise nur beobachtend oder als Hard-Cap (enforce): Bei Überschreitung werden keine neuen Läufe mehr gestartet. |
budget.daily.tokens / budget.weekly.tokens | Einstellungen | Token-Limits pro Tag bzw. Woche mit Soft-Schwelle |
| Workflow-Budget | Workflow | Greift vor dem Start des nächsten Tasks eines parallelen Workflows (Kapitel 7) |
| Kapazitätsschutz | Instanz | Begrenzt die Zahl gleichzeitiger Läufe |
| Ein aktiver Run je Workspace | Projekt | Pro Projekt-Workspace läuft immer nur ein Run gleichzeitig; verschiedene Projekte und getrennte Worktrees laufen parallel |
Eine bekannte Grenze: Die Auswertung je Seat gibt es (/mandanten/seat-kosten), der Hard-Cap wirkt aber nur je Mandant. Wer Nutzer einzeln begrenzen muss, braucht dafür heute organisatorische Regeln oder getrennte Mandanten.
Empfohlene Reihenfolge beim Einrichten
- Erst beobachten: Budget je Mandant ohne
enforcesetzen und ein, zwei Wochen typische Läufe sammeln. - In
/analyticsauswerten, welche Projekte und Run-Arten den Verbrauch treiben. - Dann den Hard-Cap mit Puffer aktivieren und Token-Limits als Frühwarnung setzen.
- Zum Üben ohne Kosten den
mock-Adapter verwenden (SOFTWAREFABRIK_EXECUTION_ADAPTER=mock): Er durchläuft den kompletten Run-Lebenszyklus ohne echten Agenten.
10.4 Mandanten, Rollen und das Vier-Augen-Prinzip
Sobald mehr als eine Person mit Agenten arbeitet, stellen sich zwei Fragen: Wer darf was? und Wer sieht was? Die erste beantwortet ein Rollenmodell (RBAC, Role-Based Access Control), die zweite eine Mandantentrennung.
Rollen: abgestufte Rechte
Gute Rollenmodelle für Agentenplattformen trennen mindestens drei Dinge: Lesen, Ausführen und Freigeben. Ausführen heißt, Agenten Code schreiben zu lassen — das kostet Geld und verändert Repositories. Freigeben heißt, die Verantwortung für ein Ergebnis zu übernehmen. Wer diese Rechte nicht trennt, verliert das Vier-Augen-Prinzip: Dieselbe Person beauftragt den Agenten und winkt sein Ergebnis durch.
Mandanten: harte Sichtgrenzen
Ein Mandant ist eine abgeschottete Einheit — etwa eine Abteilung, ein Kunde oder eine Tochtergesellschaft. Daten eines Mandanten dürfen für andere nicht sichtbar sein, auch nicht über geratene IDs. Das ist mehr als eine Komfortfunktion: Agentenläufe enthalten Quellcode, Anforderungen, Logs und Kosten, also häufig vertrauliche Informationen.
Single Sign-On
In Unternehmen kommt die Identität meist aus einem zentralen Identitätsanbieter (OIDC). Ein wichtiger Sicherheitsgrundsatz dabei: Die Anbindung darf Zugriff nie versehentlich erweitern. Neue, automatisch angelegte Nutzer sollten minimal berechtigt starten; die eigentliche Zuordnung bleibt eine bewusste administrative Handlung.
In der Fabrik
Rollen, Mandanten und SSO
Rollenmodell
Die Fabrik kennt fünf Rollen in aufsteigender Reihenfolge: VIEWER < DEVELOPER < MAINTAINER < OWNER < ADMIN.
| Fähigkeit | ab Rolle |
|---|---|
| Lesen | VIEWER |
| Runs ausführen, Specs anlegen und bearbeiten | DEVELOPER |
| Runs freigeben, Specs freigeben, Integrationen/Secrets verwalten | MAINTAINER |
| Mandanten-Administration | ADMIN (die Stufe OWNER ist vorgesehen, trägt derzeit aber keine eigenen Rechte) |
| Kontenverwaltung, Policy-as-Code, Compliance-Profile, Attestierung, Export | ADMIN |
Konten verwaltest du unter /admin/nutzer (nur ADMIN): anlegen, Mandant und Rolle zuweisen, aktiv/inaktiv setzen, Passwort zurücksetzen. Ein Lockout-Schutz verhindert, dass der letzte aktive Administrator herabgestuft oder deaktiviert wird. Mit run.approval-segregation erzwingst du Segregation of Duties: Wer einen Run ausgelöst hat, darf ihn nicht selbst freigeben.
Mandanten
Unter /mandanten legst du Mandanten an und ordnest Projekte zu. Ein Nutzer gehört zu genau einem Mandanten; ohne Mandant läuft die Instanz im Einzel-Mandanten-Betrieb. Projekte, Runs und alle abgeleiteten Daten sind mandanten-gescopt — ein Zugriff über eine fremde ID scheitert, abgesichert durch einen eigenen Test. Policy, Audit, Kosten und Export sind je Mandant getrennt. Für maximale Trennung (z. B. VS-NfD) bleibt eine eigene Instanz je Mandant die konservativste Variante.
SSO
OIDC-Anmeldung ist optional und konfigurationsgesteuert. Nutzer, die beim ersten SSO-Login automatisch angelegt werden (Just-in-Time-Provisioning), erhalten bewusst die Rolle VIEWER ohne Mandant. Rolle und Mandant weist anschließend ein Administrator zu.
Modell- und Adapter-Governance in drei Ebenen
- Global:
execution.adapter.defaultund die Standardmodelle in den Einstellungen. - Projekt: erlaubte Adapter je Projekt, gepflegt als Modell-Policy auf der Projektseite (ab MAINTAINER). Sie wird beim Anlegen eines Runs erzwungen; ein Verstoß erzeugt
RUN_POLICY_DENIED. - Mandant: Policy-as-Code (
/policy-as-code, FelderlaubteAdapter, Kapitel 9) kann die erlaubten Adapter mandantenweit einschränken. Eine Mandanten-Policy kann die globale nur verschärfen, nie unterlaufen.
Ein Run mit nicht erlaubtem Adapter wird abgelehnt und als RUN_POLICY_DENIED dokumentiert.
10.5 Betriebsformen und Betriebsmodi
Agentenplattformen werden sehr unterschiedlich betrieben: von der Einzelperson am eigenen Laptop bis zur abgeschotteten Behördeninstallation ohne Internet. Die Betriebsform entscheidet über drei Fragen:
- Wie kommt das Modell ins Spiel? Persönliches Abo, API-Key, Cloud-Gateway oder lokales Modell.
- Wie viele Menschen teilen sich die Instanz? Davon hängen Rollen, Mandanten und Budgets ab.
- Wie viel Netz ist erlaubt? Von „alles“ bis „nichts“ (Air-Gap).
Ein Punkt verdient besondere Aufmerksamkeit: Persönliche Abos sind persönlich. Ein Abo, das für die individuelle Nutzung eines Coding-Agenten gedacht ist, ist kein Zugang, den sich ein Team über eine gemeinsame Plattform teilen sollte. Sobald mehrere Personen eine Instanz nutzen, gehören die Läufe auf API-Keys oder ein Gateway — mit sauberer Abrechnung und klaren Nutzungsbedingungen.
Konfiguration ohne Neustart
Für den Alltag hilfreich ist eine Konfigurationshierarchie: allgemeine Vorgaben global, Abweichungen pro Nutzer oder Projekt. So muss nicht jedes Projekt alles neu festlegen, und Sonderfälle bleiben sichtbar an ihrem Ort.
In der Fabrik
Betriebsmodus, Betriebsformen, Lizenz-Tiers und Einstellungen
Betriebsmodus betrieb.modus
| Modus | Gedacht für | Wirkung |
|---|---|---|
EINZELPLATZ_ABO | Persönliche Nutzung: Der Abo-Inhaber betreibt die Fabrik selbst auf seinem eigenen Rechner, mit seinem eigenen Abo, an der unveränderten CLI | Abo-Modus (execution.<adapter>.auth-mode=subscription) für Claude, Codex und Kimi möglich; ein gesetzter API-Key wird dann aktiv aus dem Subprozess entfernt |
TEAM_API_POOL | Mehrere Personen auf einer Instanz | Sperrt den Abo-Login und erzwingt den API-Key-Modus |
Ob im Modus TEAM_API_POOL ein Key vorhanden ist, prüft die Fabrik nicht. Für Claude Code muss ANTHROPIC_API_KEY in der Umgebung des App-Prozesses stehen; ein unter /integrations gespeicherter Anthropic-Key wird laut Administrationshandbuch (v0.38.0) angezeigt und validiert, aber derzeit nicht an die CLI weitergegeben.
Betriebsformen
| Form | Beschreibung |
|---|---|
| Einzelplatz | Eine Person, ein Rechner, meist Abo-Modus einer Coding-CLI; Postgres im Container, Fabrik nativ |
| Team | Mehrere Nutzer auf einer Instanz, RBAC aktiv |
| Mehrmandantig | Mehrere voneinander abgeschottete Mandanten auf einer Instanz |
| Air-Gap | Ohne Netzzugang: Adapter local-llm (z. B. Ollama, vLLM, LM Studio), Container-Sandbox mit --network=none, Lizenz ohne Rückkanal, PR-Poller aus |
Nicht abgedeckt ist eine öffentliche SaaS-Bereitstellung mit Selbstregistrierung.
Lizenz-Tiers
Die Fabrik gibt es in drei Tiers mit demselben signierten Lizenzformat. Runs, Agenten und Team-Features laut Lizenzmodell, die Spec-Zeilen laut Administrationshandbuch (Abschnitt 13b) und SPEC-005:
| Kriterium | Community | Professional | Enterprise |
|---|---|---|---|
| Runs pro Tag | 10 | 100 | 1000 |
| Parallele Agenten | 3 | 10 | 50 |
| Team-Features, SSO, Audit-Log | — | — | ja |
| Specs (Spec-Driven Development) | — | ja | ja |
| SDD-Governance (Policy-Pflicht, Export 2.1, Kennzahlen; Zielzustand nach SPEC-005) | — | — | ja |
Ohne aktives Lizenzsystem (softwarefabrik.license.v1.enabled=false) entscheidet allein das jeweilige Feature-Flag, etwa softwarefabrik.spec.enabled. LLM-Kosten sind in keiner Lizenz enthalten; die Modellnutzung rechnest du direkt mit dem Anbieter ab.
Einstellungen
Alle Einstellungen folgen der Scope-Hierarchie PROJECT > USER > GLOBAL > YAML und wirken ohne Neustart, mit höchstens fünf Minuten Cache; Werte, die du über die Oberfläche änderst, gelten sofort. Jede Änderung erzeugt einen Audit-Eintrag. Vendor-Keys pflegst du nicht in den Einstellungen, sondern unter /integrations — AES-GCM-verschlüsselt, mit Provider-Validierung.
Monitoring und Backup
/actuator/health(inkl. Secrets-Health),/actuator/info(Version, Buildnummer),/actuator/prometheus(Metriken, nur ADMIN).- Zu sichern sind drei Dinge: die PostgreSQL-Datenbank, das Workspace-Verzeichnis mit den Git-Repositories der Projekte und der Attestierungs-Schlüssel samt Secrets-Master-Key.
- Nach jedem Restore die Kettenprüfung unter
/attestierungausführen: Ein unvollständiges Backup fällt dort alsCHAIN_BREAKauf.
10.6 Zusammenfassung
- Modellklassen nach Aufgabe wählen: stark für Planung, Arbeitspferd für den Bau, klein für Reviews — und die Wahl messen.
- Agentenkosten wachsen mit Runden mal Kontextgröße. Präzise Aufträge und kleiner, stabiler Kontext sind die größten Hebel.
- Prompt-Caching belohnt stabile Präfixe; Cache-Schreiben kostet etwas mehr, Lesen deutlich weniger.
- Wiederholen nur mit neuer Information.
- Die Fabrik löst das Modell nach Override → Team → Rollen-Default (nur Claude) → CLI-Wahl auf und attestiert die Quelle.
- Euro-Werte im Claude-Abo-Modus sind Schätzungen zum API-Tarif, keine Rechnung.
- Budgets erst beobachtend, dann als Hard-Cap je Mandant; Seat-Sicht wertet aus, begrenzt aber nicht.
- Rollen trennen Ausführen und Freigeben; ADMIN ist kein Daten-Super-Admin; SSO-Nutzer starten als VIEWER ohne Mandant.
- Persönliche Abos gehören in den Einzelplatz; Teams arbeiten im
TEAM_API_POOL.
Übung
Übung: Ein Kosten- und Modellkonzept für ein Team
Ausgangslage: Ein Team aus fünf Entwickler:innen und einer technischen Leitung will die Fabrik für zwei Produkte einsetzen. Produkt A ist ein internes Werkzeug, Produkt B verarbeitet Kundendaten. Die Leitung möchte, dass niemand eigene Läufe selbst freigibt und dass die Kosten pro Produkt sichtbar sind.
- Lege fest, welcher Betriebsmodus passt, und begründe es in einem Satz.
- Skizziere ein Rollenkonzept: Wer bekommt
DEVELOPER, werMAINTAINER, werADMIN? Welche Einstellung sorgt dafür, dass niemand seinen eigenen Run freigibt? - Entscheide, ob du einen oder zwei Mandanten anlegst. Welche Vor- und Nachteile hat jede Variante für Kostenausweis und Sichtbarkeit?
- Lege eine Modellstrategie für Plan-, Build- und Review-Läufe fest. Über welche Einstellungen bzw. Team-Felder setzt du sie um, und wo prüfst du nach einem Lauf, ob sie gegriffen hat?
- Plane die Budgeteinführung in drei Schritten.
Lösungsskizze
(1) TEAM_API_POOL, weil mehrere Personen eine Instanz nutzen; persönliche Abos sind für den Einzelplatz gedacht. (2) Die fünf Entwickler:innen als DEVELOPER, zwei erfahrene Personen zusätzlich als MAINTAINER für Freigaben, ein dediziertes Betriebskonto als ADMIN für Mandanten, Konten und Budgets; run.approval-segregation aktivieren. (3) Zwei Mandanten trennen Sichtbarkeit, Policy und Budget sauber — sinnvoll, weil Produkt B Kundendaten verarbeitet und strengere Regeln braucht; Nachteil: Nutzer gehören zu genau einem Mandanten, wer an beiden Produkten arbeitet, braucht eine organisatorische Lösung. Mit einem Mandanten reichen die Projektkosten in /analytics für den Kostenausweis. (4) Plan-Runs mit einem starken Modell (run.routing.plan-model), Build-Runs mit dem Arbeitspferd (run.routing.build-model oder preferredModel des Developer-Agenten), Reviews mit dem kleinen Review-Modell; Prüfung im Warum-Trace über RUN_MODELL_AUFGELOEST und das Feld quelle. (5) Beobachtendes mandant_budget → Auswertung in /analytics und /mandanten/kosten → Hard-Cap mit Puffer plus Token-Limits als Frühwarnung.
Kapitelfragen
-
Warum lohnt sich für Planungsläufe oft ein teureres Modell als für Build-Läufe?
Musterantwort
Planungsfehler vervielfachen sich, weil alle folgenden Build-Läufe auf dem Plan aufbauen. Gleichzeitig erzeugt ein Plan-Lauf vergleichsweise wenig Output. Die Mehrkosten pro Token treffen also auf wenige Tokens und verhindern teure Folgefehler. Build-Läufe erzeugen dagegen das meiste Volumen bei eher mechanischer Arbeit, wo ein mittleres Modell meist genügt.
-
Erkläre, warum die Kosten eines Agentenlaufs nicht linear mit der Größe der Aufgabe wachsen.
Musterantwort
In jeder Runde der Agenten-Schleife wird der gesamte bisherige Kontext erneut verarbeitet: Anweisungen, Projektkontext, alle Werkzeugaufrufe und ihre Ergebnisse. Die Kosten wachsen daher grob mit der Zahl der Runden mal der Kontextgröße. Unklare Aufträge erhöhen beides, große eingelesene Ausgaben blähen jede Folgerunde auf.
-
Ein Build-Run mit dem Adapter
claudelief mit Sonnet, obwohl du am Developer-Agenten Opus eingetragen hast. Welche Ursache ist am wahrscheinlichsten, und wo prüfst du das?Musterantwort
Ein Routing-Override
run.routing.build-modelhat Vorrang vor dem Wunschmodell des Teams. Alternativ wurde ein anderes Team gewählt. Im Warum-Trace (/runs/{id}/trace) zeigtRUN_MODELL_AUFGELOESTmitquelle=override,team,rollen-defaultoderadapter-default, woher das Modell kam. -
Warum bekommt ein Lauf mit dem Adapter Aider keinen Claude-Rollen-Default?
Musterantwort
Aider (wie auch Bedrock/Vertex/Azure, Local-LLM und Kimi) reicht
--modelunverändert an seine eigene CLI bzw. sein Backend durch. Ein Claude-Modellname wäre dort falsch oder bedeutungslos. Für diese Adapter gelten das Standardmodell je Adapter oder die Wahl der CLI. -
In der Kostensicht steht für einen Claude-Lauf ein Euro-Betrag mit dem Vermerk „Schätzung (API-Tarif), nicht abgerechnet“. Was bedeutet das, und zählt der Betrag gegen das Budget?
Musterantwort
Der Lauf lief im Abo-Modus und zählt gegen die Nutzungslimits des Abos, eine API-Rechnung entsteht nicht. Die Fabrik bewertet die Tokens trotzdem zum API-Tarif, um die erzeugte Last sichtbar zu machen. Der Betrag zählt im Verbrauch und damit gegen Budget und Hard-Cap.
-
Ein Lauf mit mehreren hunderttausend Tokens erscheint mit 0 €. Welche zwei Erklärungen gibt es?
Musterantwort
Entweder ist es ein Flatrate-Modell (z. B.
k3,kimi-for-coding), für das bewusst 0 € geführt werden, oder das Modell hat keinen Eintrag in der Preistabelle inapplication.ymlund wird konservativ mit 0 € bewertet. Im zweiten Fall sollte die Tabelle ergänzt werden. -
Eine Administratorin beschwert sich, dass sie die Projekte eines anderen Mandanten nicht sieht. Ist das ein Fehler? Was ist zu tun?
Musterantwort
Kein Fehler:
ADMINist in der Fabrik kein Super-Admin für Daten. Projekte, Runs, Logs und Kosten bleiben mandanten-gescopt. Isolationsfrei sind nur Kontenverwaltung und Projektzuweisung. Lösung über die Mandantenzuweisung (Konto bzw. Projekt dem richtigen Mandanten zuordnen) oder eine bewusste organisatorische Regelung. -
Warum erhalten per SSO neu angelegte Nutzer die Rolle
VIEWERohne Mandant, und welches allgemeine Prinzip steckt dahinter?Musterantwort
Eine SSO-Anbindung darf Zugriff nie versehentlich erweitern. Minimale Rechte beim ersten Login und eine bewusste administrative Zuordnung von Rolle und Mandant setzen das Prinzip der geringsten Rechte (least privilege) und der fail-safe defaults um.
-
Transfer: Du sollst die Agentenkosten deines Teams um ein Drittel senken. Nenne drei Maßnahmen in der Reihenfolge, in der du sie prüfen würdest, und begründe die Reihenfolge.
Musterantwort
Beispiel: (1) Aufträge präzisieren und kleiner schneiden (Specs mit Akzeptanzkriterien, Backlog-Items statt Mega-Ziel), weil das Runden und Kontext zugleich reduziert. (2) Wiederholungen ohne neue Information abstellen und Korrekturschleifen auswerten, weil blinde Retries reine Verschwendung sind. (3) Erst danach die Modellklassen je Aufgabe anpassen und die Wirkung in
/analyticsmessen, weil ein günstigeres Modell mit mehr Korrekturen am Ende teurer sein kann. -
Welche drei Dinge musst du sichern, und warum gehört der Attestierungs-Schlüssel dazu?
Musterantwort
Die PostgreSQL-Datenbank, das Workspace-Verzeichnis mit den Git-Repositories und den Attestierungs-Schlüssel samt Secrets-Master-Key. Ohne den Attestierungs-Schlüssel lässt sich die signierte Audit-Kette später nicht mehr verifizieren; ohne Master-Key sind gespeicherte Secrets nicht mehr lesbar. Nach dem Restore zeigt die Kettenprüfung unter
/attestierung, ob die Sicherung vollständig war.