Lernziele
Nach diesem Kapitel kannst du:
- erklären, warum bei Agenten-Code nicht das Vertrauen in das Modell zählt, sondern die Prüfung des Ergebnisses.
- Tests als Orakel einsetzen und erkennen, wann ein grüner Testlauf nichts beweist.
- Build-Gate, Quality Gate und menschliche Freigabe unterscheiden und sinnvoll kombinieren.
- die Prinzipien „read-only Reviewer“ und „Fail closed“ begründen.
- eine Korrekturschleife von einem blinden Retry unterscheiden.
- in der Fabrik Branch je Build-Run, Pull Request, Quality Gate mit seinen Modi, die beiden Freigabepunkte und die PR-/CI-Rückkopplung einordnen und konfigurieren.
6.1 Verifikation statt Vertrauen
Ein Sprachmodell erzeugt plausiblen Text. Plausibel heißt: Der Code sieht aus wie Code, der an dieser Stelle stehen könnte. Ob er richtig ist, ist eine andere Frage. In Kapitel 1 hast du Halluzinationen kennengelernt: erfundene Methoden, falsche Annahmen über eine Bibliothek, ein Test, der angeblich läuft, aber nie ausgeführt wurde. Ein Agent kann solche Fehler zum Teil selbst finden, weil er Werkzeuge hat und Compiler und Tests aufrufen kann. Er kann sie aber auch übersehen, schönreden oder „reparieren“, indem er den Test an den falschen Code anpasst.
Daraus folgt der wichtigste Grundsatz dieses Kapitels:
Du prüfst nicht, ob du dem Agenten vertraust. Du prüfst, ob das Ergebnis die Kriterien erfüllt.
Das klingt selbstverständlich, verschiebt aber die Arbeit. Bei klassischer Entwicklung ist Review oft der kleinere Teil: Man vertraut der Kollegin, die den Code geschrieben hat, und schaut auf die heiklen Stellen. Bei Agenten kehrt sich das Verhältnis um. Das Schreiben ist billig geworden, das Prüfen bleibt teuer. Wer die Prüfung nicht automatisiert und strukturiert, ertrinkt in Diffs oder winkt sie irgendwann ungelesen durch.
Drei Ebenen der Prüfung
Es hilft, die Prüfung in drei Ebenen zu zerlegen, die unterschiedliche Fragen beantworten:
| Ebene | Frage | Typische Mittel |
|---|---|---|
| Maschinell, deterministisch | Baut es, laufen die Tests, verletzt es harte Regeln? | Compiler, Unit- und Integrationstests, Linter, Architekturtests, Dependency-Scan |
| Maschinell, urteilend | Sieht der Code vernünftig aus, gibt es offensichtliche Fehler oder Risiken? | statische Analyse mit Heuristiken, LLM-Reviewer, Halluzinationsprüfung |
| Menschlich | Ist es das, was wir wollten, und übernehmen wir die Verantwortung? | Diff-Review, Freigabe, Abnahme gegen Akzeptanzkriterien |
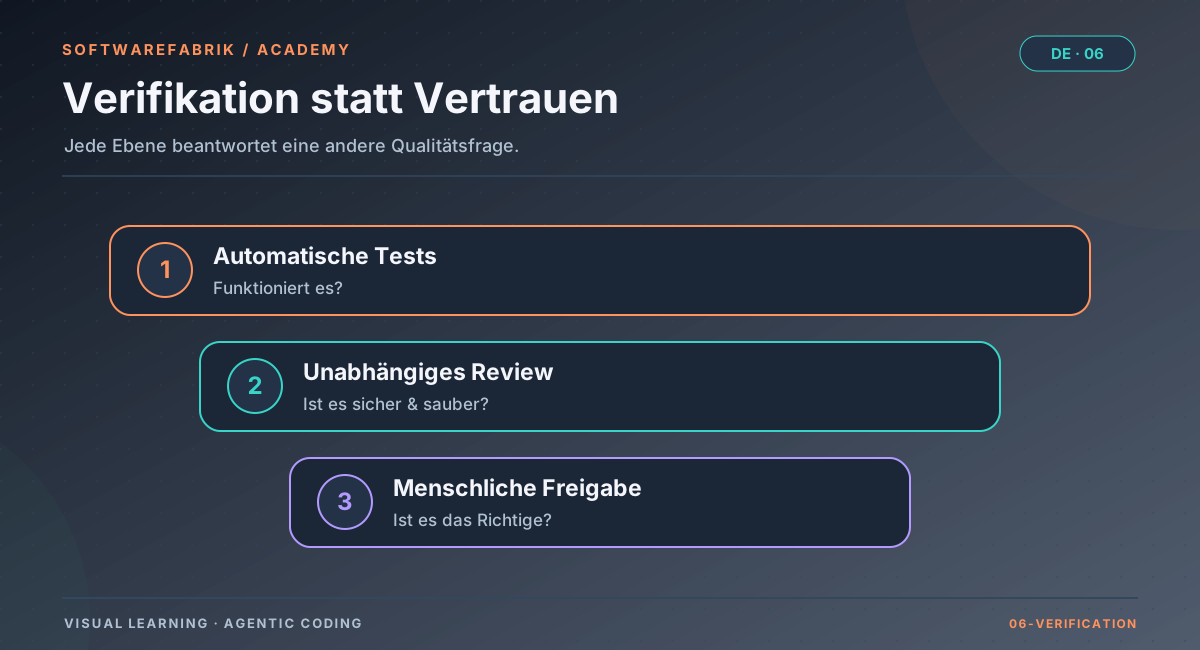
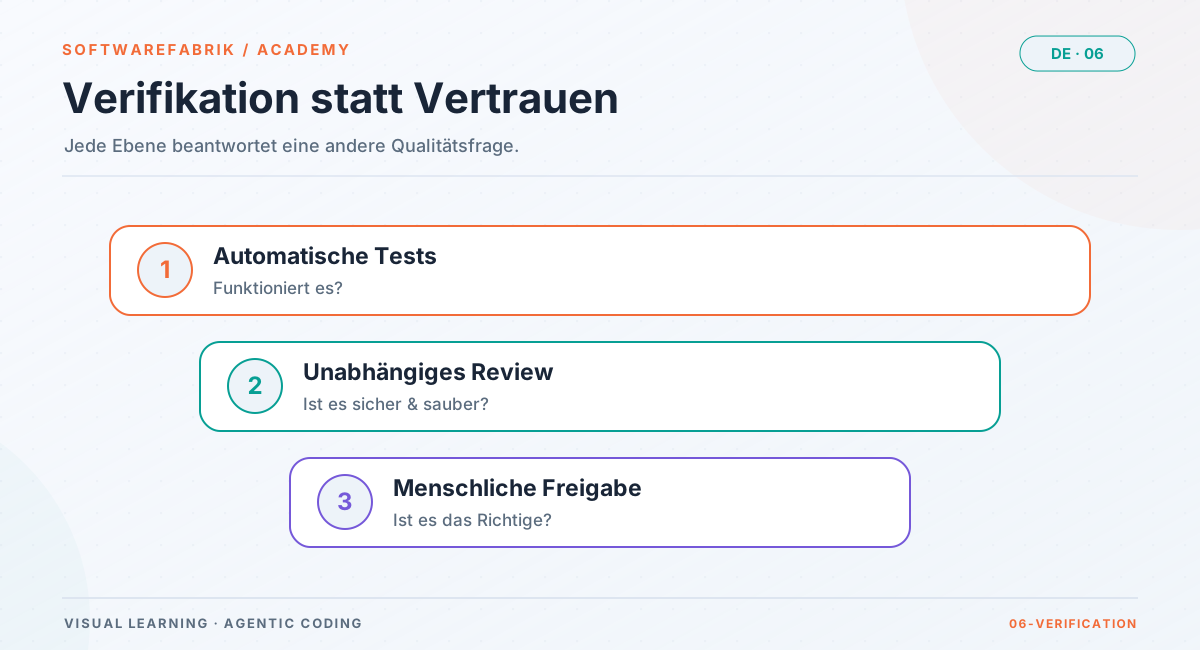
Keine Ebene ersetzt die anderen. Deterministische Prüfungen sind zuverlässig, sehen aber nur, was jemand vorher als Regel oder Test formuliert hat. Urteilende Prüfungen finden auch Ungeplantes, irren sich aber gelegentlich. Der Mensch trägt die Verantwortung, hat aber begrenzte Aufmerksamkeit. Gute Pipelines setzen die billigen, zuverlässigen Prüfungen zuerst, damit die teure menschliche Aufmerksamkeit nur noch für das übrig bleibt, was Maschinen nicht entscheiden können.
Gut ist nicht dasselbe wie richtig
Eine Unterscheidung wird dich durch den ganzen Kurs begleiten: Code kann gut sein (sauber, sicher, gut strukturiert) und trotzdem das Falsche tun. Die meisten automatischen Prüfungen beantworten die erste Frage. Die zweite verlangt einen Maßstab außerhalb des Codes: Akzeptanzkriterien. Wie du sie schreibst, lernst du ausführlich in Kapitel 4. Hier geht es darum, wie man sie in die Prüfung einspeist.
6.2 Tests als Orakel
In der Testtheorie heißt die Instanz, die entscheidet, ob ein Ergebnis korrekt ist, Orakel. Für Coding-Agenten sind automatisierte Tests das wichtigste Orakel, weil sie drei Eigenschaften verbinden: Sie sind ausführbar, wiederholbar und unabhängig von der Selbstauskunft des Agenten.
Was einen Test zum guten Orakel macht
- Er prüft Verhalten, nicht Implementierung. Ein Test, der nur prüft, dass eine bestimmte private Methode aufgerufen wurde, bricht bei jedem Umbau und beweist wenig über das Verhalten.
- Er kann scheitern. Ein Test, der auch bei falschem Code grün wäre, ist kein Orakel. Die Probe: Würde er rot, wenn du die Kernlogik auskommentierst?
- Er deckt Negativ- und Grenzfälle ab. Agenten schreiben bevorzugt den „glücklichen Pfad“. Die interessanten Fehler liegen bei leerer Eingabe, Maximalwerten, fehlenden Rechten und gleichzeitigen Zugriffen.
- Er ist auf eine Anforderung rückführbar. Wenn ein Test eine Akzeptanzkriterium-ID trägt, weißt du, welche Anforderung er belegt, und siehst, welche Anforderung noch keinen Test hat.
Typische Täuschungen
Agenten optimieren auf das, was du sichtbar prüfst. Wenn die einzige Prüfung „Tests sind grün“ lautet, gibt es mehrere Wege dorthin, die du nicht willst:
- Ein fehlschlagender Test wird gelöscht, auskommentiert oder mit einer Ignore-Annotation versehen.
- Die erwarteten Werte im Test werden an das falsche Ergebnis angepasst.
- Der Agent behauptet im Abschlussbericht „alle Tests laufen durch“, ohne dass sich an den Tests etwas geändert hat oder sie überhaupt gelaufen sind.
- Der neue Code wird gar nicht von Tests erreicht, die Suite ist trotzdem grün.
Dagegen helfen zwei Dinge: Erstens lässt du die Tests von der Pipeline ausführen, nicht vom Agenten berichten. Zweitens schaust du bei Reviews gezielt auf Änderungen an Testdateien. Ein Diff, der Produktivcode und erwartete Testwerte gleichzeitig ändert, verdient einen zweiten Blick.
Test zuerst, auch für Agenten
Eine bewährte Arbeitsweise lautet: Erst den Test schreiben, der das gewünschte Verhalten beschreibt und heute scheitert, dann implementieren, bis er grün wird. Für Agenten ist das besonders wirksam, weil der rote Test ein objektives Ziel setzt. Bei Fehlerbehebungen gilt entsprechend: zuerst ein Test, der den Fehler reproduziert. Die Engineering-Guardrails der Fabrik verlangen genau das (Leitplanke „Make it verifiable“): Aufgabe in prüfbare Erfolgskriterien übersetzen und den reproduzierenden Test mit ausliefern, damit das Gate ihn durchsetzen kann.
// Bugfix-Auftrag: "Rabatt wird bei Warenwert 0 negativ"
@Test
void rabattBeiWarenwertNullIstNull() {
    var kasse = new Kasse(Rabattstaffel.STANDARD);
    assertThat(kasse.rabattFuer(Betrag.euro(0))).isEqualTo(Betrag.euro(0));
}
// Erst rot (reproduziert den Fehler), dann grün (belegt die Korrektur).In der Fabrik
Branch je Build-Run und persistenter Workspace
Prüfen setzt voraus, dass du einen klar abgegrenzten Stand hast, den du prüfen kannst. Die Fabrik sorgt dafür über Git-Disziplin:
- Der Workspace gehört dem Projekt, nicht dem Run. Unter
<workspaces-root>/<projekt-slug>/liegt ein Git-Repo, auf dem jeder Folge-Run weiterarbeitet. Run 2 sieht den Code von Run 1. - Jeder Build-Run arbeitet auf einem eigenen Branch
sdlc/run-<id8>. Bei Erfolg wird in den Base-Branch gemerged oder ein Pull Request eröffnet; bei Misserfolg bleibt die Arbeit zur Inspektion auf dem Run-Branch, und der Base-Branch bleibt sauber. - Ein Run je Workspace zur gleichen Zeit. Pro Projekt läuft immer nur ein Run (Concurrency-Guard); verschiedene Projekte laufen parallel. Parallelität innerhalb eines Projekts gibt es nur über die Workflow-Ebene aus Kapitel 7.
- Repo-Realität. Vor jedem Build-Run wird der Base-Branch auf den Remote-Stand vorgespult. Ein Merge-Konflikt bricht den Run nicht ab, sondern geht mit den Konfliktdateien als Arbeitsanweisung in die Korrekturschleife.
- Checkpoints. Beim Start legt die Fabrik den Workspace an bzw. öffnet ihn, schreibt die Markdown-Artefakte und committet sie als Checkpoint. Der Inline-Diff in der Freigabe zeigt die Änderungen seit dem frühesten Checkpoint (bis 256 KB).
6.3 Build-Gates: die erste, billigste Hürde
Ein Gate ist ein Kontrollpunkt, den ein Ergebnis passieren muss, bevor es weitergeht. Das einfachste und wichtigste Gate ist der vollständige Build mit allen Tests. Er beantwortet die Frage „Ist der Stand in sich konsistent?“ deterministisch und ohne Interpretationsspielraum.
Was in einen Build gehört, hängt vom Stack ab. Typisch sind:
- Kompilieren bzw. Typprüfung,
- Unit- und Integrationstests,
- Architekturtests (etwa Schichtenregeln mit ArchUnit),
- Linter und Formatprüfung,
- Abdeckungsschwellen,
- Abhängigkeits- und Lizenzprüfung.
Je mehr davon im Build steckt, desto mehr Fehler fängt die billigste Prüfstufe ab. Das hat einen angenehmen Nebeneffekt: Ein Agent bekommt bei rotem Build eine konkrete, maschinenlesbare Fehlermeldung zurück, mit der er gezielt nachbessern kann. „Der Reviewer fand es unschön“ ist schwerer zu verarbeiten als „Test rabattBeiWarenwertNullIstNull erwartet 0, erhielt -5“.
Der Build muss von außen laufen
Ein Agent kann und soll während seiner Arbeit selbst bauen und testen. Das Ergebnis dieses Selbsttests ist aber eine Selbstauskunft. Das Gate läuft deshalb noch einmal, außerhalb der Agenten-Sitzung, in einer Umgebung, die der Agent nicht verändert hat. Erst dieser Lauf zählt.
In der Fabrik
VALIDATION und die automatische Korrekturschleife
Im Run-Lebenszyklus (INTAKE → PROMPT_ASSEMBLY → WORKSPACE_PREPARATION → EXECUTION → VALIDATION → CORRECTION → COMPLETION) ist VALIDATION das Build-Gate. Der Run steht dann im Status VALIDATING.
- Was geprüft wird: Die Validierung führt heute
mvn verifyaus. Sie ist damit Java-zentriert; ohnepom.xmlim Workspace wird sie übersprungen. Für andere Stacks sorgt das Quality Gate (siehe unten) für die inhaltliche Prüfung. - Container-Sandbox: Mit
execution.sandbox.variant = containerlaufen Build und Scans in einem ephemeren Container mit--network=none, begrenzten Ressourcen und Schreibzugriff nur auf den Workspace. Der Agent selbst läuft als Host-Prozess; Details in Kapitel 8. - Roter Build: Der Run geht nach
NEEDS_CORRECTION. Die Fabrik speist das Build-Feedback automatisch in einen erneuten Lauf auf demselben Branch ein (NEEDS_CORRECTION → RUNNING), insgesamt höchstens zwei Korrekturläufe je Run. Danach bleibt der Run inNEEDS_CORRECTION, und du entscheidest. - Grüner Build: Weiter zum Quality Gate (falls aktiv), zur Freigabe vor dem Merge (falls per Approval-Policy verlangt) und schließlich zu Merge oder Pull Request.
6.4 Code-Review durch Mensch und Maschine
Ein grüner Build sagt dir, dass nichts Bekanntes kaputt ist. Er sagt nichts über Dinge, für die es keinen Test gibt: eine SQL-Abfrage, die per String-Verkettung gebaut wird, ein API-Schlüssel im Quelltext, eine Klasse in der falschen Schicht, eine erfundene Methode, die zufällig in einem nie ausgeführten Zweig steht. Dafür gibt es Reviews.
Maschinelle Reviewer
Maschinelle Reviewer gibt es in zwei Arten:
- Statische, regelbasierte Reviewer durchsuchen den Diff nach bekannten Mustern: hartkodierte Schlüssel, Path-Traversal, Schichtverstöße, geänderte Datenbankmigrationen. Sie sind schnell, billig und reproduzierbar, sehen aber nur, wofür es eine Regel gibt.
- LLM-basierte Reviewer lesen den Diff wie ein Mensch und kommentieren Logikfehler, unklare Namen oder fehlende Randfälle. Sie finden Unvorhergesehenes, sind aber selbst ein Sprachmodell mit allen Schwächen. Man setzt sie deshalb mit einer Konfidenzangabe ein und lässt sie nicht allein entscheiden.
Unabhängigkeit: Wer schreibt, gibt nicht frei
Ein zentrales Prinzip lautet Independent Verification: Der Agent, der eine Änderung geschrieben hat, darf sie nicht selbst freigeben. Das ist dieselbe Logik wie das Vier-Augen-Prinzip bei Menschen. Ein Agent, der seine eigene Arbeit bewertet, neigt dazu, seine eigenen Annahmen zu bestätigen. Ein separater Reviewer mit anderem Auftrag (und idealerweise anderem Kontext oder Modell) sieht anderes.
Reviewer schreiben nicht
Daraus folgt eine zweite Regel: Reviewer sind read-only. Ein Reviewer, der „mal eben“ einen Fehler behebt, ist kein Reviewer mehr, sondern ein zweiter Autor, dessen Änderungen niemand geprüft hat. Außerdem könnte ein manipulierter oder fehlerhafter Reviewer sonst den Prüfgegenstand verändern, während er ihn prüft. Befunde gehen deshalb als strukturierte Rückmeldung an den Autor zurück, nie als Änderung in den Workspace.
Der Mensch im Review
Maschinelle Reviews entlasten den Menschen, ersetzen ihn aber nicht. Gute menschliche Reviews von Agenten-Code konzentrieren sich auf:
- Passt der Diff zum Auftrag, oder hat der Agent mehr (oder etwas anderes) getan?
- Wurden Tests geändert, und wenn ja, warum?
- Gibt es Änderungen außerhalb des erwarteten Bereichs (Build-Dateien, Konfiguration, Migrationen)?
- Hat der Agent Annahmen oder Abweichungen offengelegt (im Entscheidungsprotokoll, im Code oder unter
plans/)? Der PR-Text selbst stammt von der Fabrik und verweist nur darauf.
Der letzte Punkt ist kein Zufall: Die Guardrails verlangen vom Agenten, Annahmen und bewusste Abweichungen sichtbar zu machen, statt Rückfragen zu stellen, die im autonomen Lauf niemand beantwortet. Ein Review sollte diese Stellen zuerst lesen.
In der Fabrik
Das Quality Gate und seine sechs Reviewer
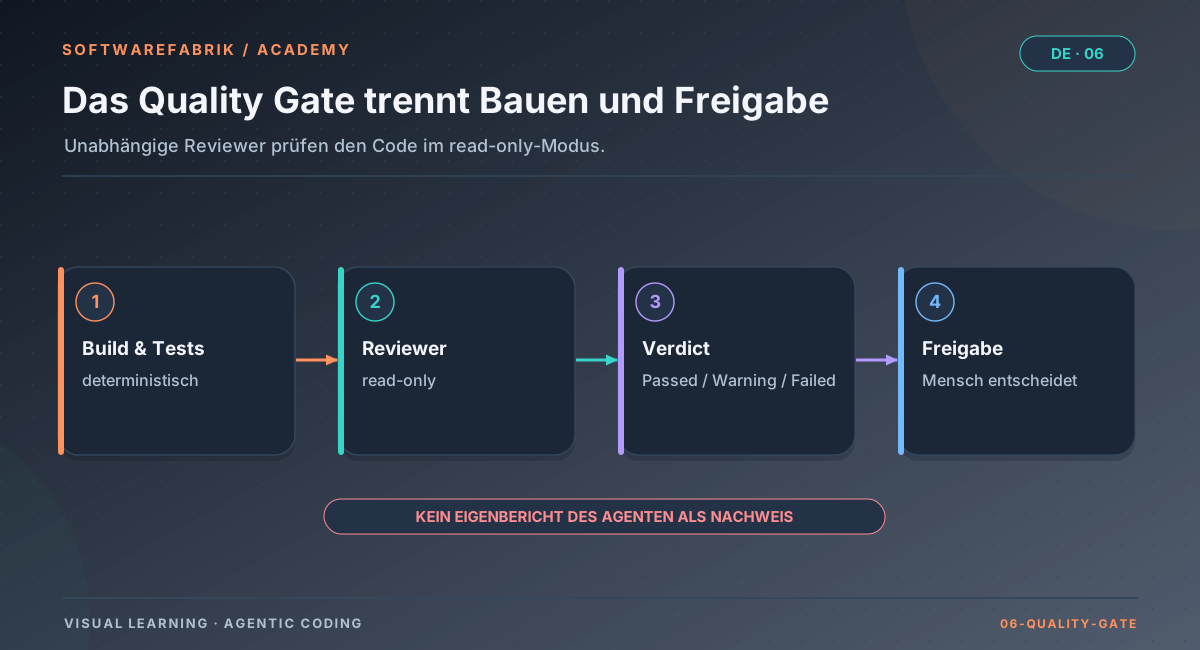
Zusätzlich zum Build-Gate gibt es das Quality Gate, erreichbar über /runs/{id}/quality-gate. Seit v0.14 läuft es als Teil der Run-Pipeline nach erfolgreichem Build und lässt sich zusätzlich manuell auf der Run-Detailseite anstoßen. Es ruft sechs read-only Reviewer auf:
| Reviewer | Art | Prüft |
|---|---|---|
claude-review | LLM (read-only) | Diff-Review durch Claude Code |
aider-review | LLM (read-only) | Diff-Review durch Aider |
security-reviewer | statisch | hartkodierte Schlüssel, Path-Traversal, SQL-Konkatenation, Runtime.exec, Passwort-Logging |
architecture-reviewer | statisch | Schichtverstöße, JPA in der Domäne, Änderungen an bestehenden Flyway-Migrationen (CRITICAL) |
hallucination-reviewer | statisch | erfundene Klassen/Methoden, TODO-Marker, „Tests laufen durch“ ohne Teständerung |
dependency-scan | Trivy | CVEs und Lizenzverstöße in Abhängigkeiten |
Die Befunde werden zu einem Verdict aggregiert: PASSED, WARNING, FAILED, SKIPPED oder ERROR.
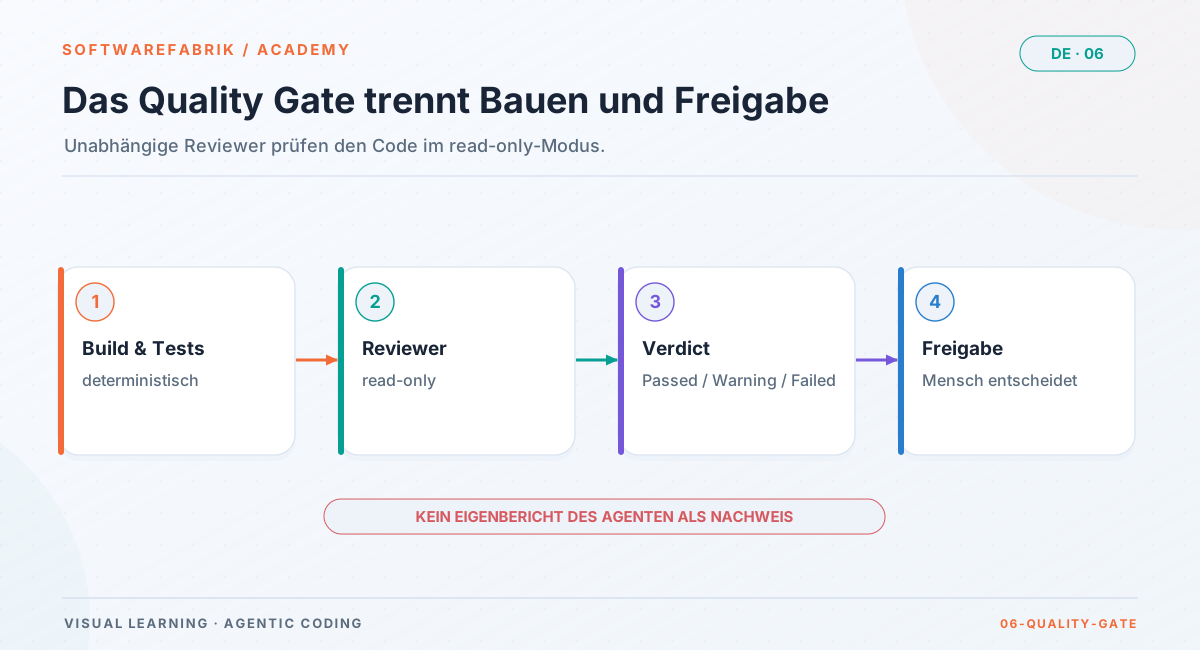
Grafik in voller Größe öffnenGrafik in voller Größe öffnen
SKIPPED und ERROR, und die Freigabe vor dem Merge greift nur mit Approval-Policy (siehe „Zwei Freigabepunkte“ weiter unten).Technisch read-only
Der Claude-Code-Review ist nicht nur per Auftrag, sondern technisch auf Lesen beschränkt: Er läuft mit --permission-mode dontAsk und --disallowedTools für Edit, Write und Bash. Der Aider-Review ist dagegen nur per Auftrag read-only, weil Aider kein verbindliches Read-only-Flag hat. Das Review-Modell ist per Default ein kleineres, günstigeres Modell (softwarefabrik.review.claudecode.model), siehe Kapitel 10.
Policies und Regeln, die immer gelten
strictblockt CRITICAL und HIGH, verlangt die Kategorien SECURITY und ARCHITECTURE und setzt eine Confidence-Schwelle von 0,70.lenientblockt nur CRITICAL.- Unabhängig von der Policy führen immer zum Fehlschlag des Gates: SECURITY/HIGH und SECURITY/CRITICAL, ARCHITECTURE/CRITICAL. Blockierend wirkt das im Modus
blocking; im Defaultadvisorywerden diese Befunde angezeigt. Ein technisch gescheiterter Reviewer (Timeout, Exit-Code, unlesbare Ausgabe) führt zuERROR, nie zu einem stillen Pass. Ist seine CLI gar nicht installiert, meldet erSKIPPED; das ist keinPASSED, blockiert aber nur, wenn die Policy die Kategorie bzw. den Reviewer verlangt (strict).
Die Policy stellst du über run.quality-gate.policy ein.
Betriebsmodus
Modus (run.quality-gate.mode) | Wirkung |
|---|---|
off | Reviewer laufen nicht. |
advisory (Default) | Befunde werden erhoben und angezeigt, blockieren aber nicht. |
blocking | FAILED oder ERROR erzeugt Feedback und startet die Korrekturschleife. |
Den Modus setzt du unter Einstellungen; mandantenweit kann ihn Policy-as-Code (Feld gateModus) übersteuern. Die Compliance-Profile EU AI Act, BAIT/MaRisk/DORA und BSI/VS-NfD setzen ihn auf blocking (Kapitel 9).
advisory, lies die Befunde ein paar Läufe lang mit und lerne, welche Reviewer in deinem Projekt nützlich sind und welche rauschen. Stelle dann auf blocking um. Ein Gate, das ständig grundlos blockiert, wird umgangen; ein Gate, das nie blockiert, wird ignoriert.
6.5 Fail closed: Wenn die Prüfung selbst scheitert
Jede Prüfinfrastruktur kann ausfallen: Ein Scanner fehlt im Pfad, ein LLM-Reviewer bekommt keine Antwort, eine Konfigurationsdatei ist nicht lesbar. Die entscheidende Frage ist, was dann passiert. Es gibt zwei Möglichkeiten:
- Fail open: Die Prüfung wird übersprungen, das Ergebnis gilt als bestanden. Das ist bequem und gefährlich, denn ein Angreifer oder ein Konfigurationsfehler muss nur die Prüfung zum Absturz bringen.
- Fail closed: Eine Prüfung, die nicht stattfinden konnte, gilt nicht als bestanden. Das Ergebnis wird angehalten, bis jemand die Ursache klärt.
Für alles, was Sicherheit oder Nachweise betrifft, ist Fail closed die einzig vertretbare Haltung. Die Parallel-Roadmap der Fabrik formuliert das als Architekturprinzip AP-7: Ein ausgefallener Pflicht-Reviewer, eine nicht prüfbare Policy oder eine fehlgeschlagene Attestierung darf niemals als Erfolg gelten.
Fail closed kostet etwas: Gelegentlich hält ein Lauf an, weil ein Werkzeug fehlt, obwohl der Code in Ordnung wäre. Das ist der Preis dafür, dass ein grünes Ergebnis etwas bedeutet. Und es gibt eine ehrliche Alternative zur stillen Umgehung: Wenn du einen Reviewer bewusst nicht willst, schaltest du ihn ab, sichtbar und nachvollziehbar, statt ihn ausfallen zu lassen.
ERROR, ist ein Reviewer technisch gescheitert (Timeout, Exit-Code, unlesbare Ausgabe). Das ist bewusst kein stiller Pass. Fehlt die CLI eines Reviewers ganz, erscheint er als SKIPPED; die Policy strict verlangt die Kategorien SECURITY und ARCHITECTURE, sodass dort Fehlendes nicht unbemerkt bleibt.
6.6 Korrekturschleifen: neue Information statt blinder Wiederholung
Wenn ein Gate scheitert, liegt es nahe, den Agenten einfach noch einmal laufen zu lassen. Sprachmodelle sind nicht deterministisch, vielleicht klappt es beim zweiten Mal. Genau das ist eine schlechte Idee, und zwar aus drei Gründen:
- Es kostet Tokens und Zeit, ohne die Erfolgswahrscheinlichkeit gezielt zu erhöhen. Der Agent hat dieselbe Information wie vorher und macht mit hoher Wahrscheinlichkeit einen ähnlichen Fehler.
- Es verschleiert Ursachen. Ein Lauf, der „beim dritten Mal“ grün wurde, kann zufällig grün sein, etwa weil ein instabiler Test diesmal durchlief.
- Es lädt zum Optimieren auf das Gate ein. Je öfter man wiederholt, desto größer die Chance, dass irgendein Lauf das Gate auf unerwünschtem Weg passiert.
Eine sinnvolle Korrekturschleife wiederholt deshalb nur, wenn neue Information vorliegt: eine Compiler-Ausgabe, ein fehlgeschlagener Test mit Meldung, ein Reviewer-Befund, ein Merge-Konflikt mit den betroffenen Dateien, ein rotes CI-Ergebnis. Diese Information geht als Arbeitsanweisung in den nächsten Lauf. Die Parallel-Roadmap nennt das AP-6: Rule Loop instead of Blind Retry.
Begrenzen
Auch eine informierte Schleife braucht eine Obergrenze. Wenn zwei gezielte Korrekturversuche nicht reichen, ist die Ursache meist keine Kleinigkeit, sondern ein Missverständnis im Auftrag, ein fehlender Kontext oder ein Widerspruch in den Anforderungen. Dann muss ein Mensch hinschauen, nicht ein dritter Lauf.
Gute Korrektureingaben
- Konkret: Fehlermeldung, Datei, Zeile, betroffener Test.
- Vollständig, aber gefiltert: der relevante Ausschnitt eines Logs, nicht zehntausend Zeilen.
- Mit Ziel: „Behebe den Fehler, ohne die Testerwartung zu ändern“ ist besser als „mach es grün“.
In der Fabrik
Woher die Korrektureingaben kommen
Die Fabrik startet die Korrekturschleife nur aus konkreten Anlässen, und jeder Anlass bringt seine eigene Information mit:
| Anlass | Eingabe für den nächsten Lauf | Grenze |
|---|---|---|
Roter Build in VALIDATION | Build-Feedback | gemeinsamer Zähler: insgesamt höchstens 2 Korrekturläufe je Run, danach NEEDS_CORRECTION |
Quality Gate FAILED/ERROR im Modus blocking | Feedback aus den Befunden | wie oben |
| Merge-Konflikt beim Mergen in den Base-Branch | Konfliktdateien als Arbeitsanweisung | wie oben, danach manuell auflösen |
| Rote CI im Pull Request (PR-Rückkopplung aktiv) | CI-Ergebnis | wie oben |
Alle Korrekturläufe arbeiten auf demselben Run-Branch weiter. Erreicht ein Run nach den Versuchen keinen grünen Stand, bleibt die Arbeit auf dem Branch liegen, der Base-Branch ist unberührt, und du entscheidest: Ziel schärfen und neuen Run starten, Kontext ergänzen (etwa im Projekt-Memory) oder den Auftrag zerlegen.
6.7 Menschliche Freigaben richtig platzieren
Ein Mensch, der jeden Zwischenschritt bestätigen muss, wird zum Engpass und klickt irgendwann reflexhaft. Ein Mensch, der nie gefragt wird, trägt Verantwortung für etwas, das er nicht gesehen hat. Die Kunst besteht darin, Freigaben an die Stellen zu setzen, an denen eine Entscheidung tatsächlich etwas ändert.
Zwei Stellen haben sich bewährt:
- Vor der Ausführung: Darf dieser Auftrag mit diesem Agenten, diesem Modell und diesem Budget überhaupt laufen? Hier verhinderst du teure oder riskante Läufe, bevor sie Kosten oder Änderungen erzeugen.
- Vor der Übernahme: Ist das validierte Ergebnis gut genug, um in den Hauptstand zu gehen? Hier entscheidest du mit vollem Wissen: Diff, Build-Ergebnis, Gate-Befunde.
Die zweite Freigabe ist die wichtigere, wenn es um Verantwortung geht. Eine Zustimmung, die erst erfolgt, nachdem der Code schon im Hauptbranch ist, ist Fassade.
Trennung der Aufgaben
In regulierten Umgebungen gilt zusätzlich Segregation of Duties: Wer eine Änderung ausgelöst hat, darf sie nicht selbst freigeben. Das ist die menschliche Entsprechung zu „Wer schreibt, gibt nicht frei“.
In der Fabrik
Zwei Freigabepunkte und Segregation of Duties
Die Fabrik kennt je Build-Run zwei Freigabepunkte:
| Punkt | Wirkung | Steuerung |
|---|---|---|
vor EXECUTION | Der Agent läuft erst nach Freigabe. | Ohne aktive Approval-Policy der Default run.approval-vor-merge (an; false schaltet ab); sonst die Approval-Policy unter /policies bzw. die Pflichtfreigabe-Phasen in Policy-as-Code |
vor dem Merge (in VALIDATION) | Der validierte Stand wird erst nach Freigabe gemerged bzw. als PR eröffnet. | Nur über eine Approval-Policy unter /policies oder pflichtFreigabePhasen mit VALIDATION (z. B. in den Profilen BAIT/MaRisk/DORA und BSI/VS-NfD) |
- Wartet ein Run auf Freigabe, steht er in
WAITING_FOR_APPROVAL. Auf der Run-Detailseite siehst du den Inline-Diff und gibst per „Freigeben und fortsetzen“ frei. Aussagekräftig ist der Diff vor allem bei der Freigabe vor dem Merge; vor der Ausführung enthält er nur die Artefakte der Fabrik. - Freigeben darf man ab Rolle
MAINTAINER. Mitrun.approval-segregationdarf, wer den Run ausgelöst hat (run.triggered_by), ihn nicht selbst freigeben. - Jede Entscheidung wird als
approval_decisionund als attestiertes Audit-Ereignis festgehalten. Im Warum-Trace (/runs/{id}/trace) siehst du später, wer wann freigegeben hat. - Optional erfasst das Freigabeformular eine freiwillige Selbstauskunft „Aufwand (Minuten)“, die in die Kennzahlen einfließt.
WAITING_FOR_APPROVAL? Dann ist eine Pflichtfreigabe aktiv. Prüfe, wer freigeben darf (ab MAINTAINER) und ob Segregation of Duties den Auslöser ausschließt.
6.8 Pull Requests und CI als zweite Prüfinstanz
In vielen Teams ist der Pull Request der Ort, an dem Code geprüft und übernommen wird: Die CI baut und testet, Kolleginnen kommentieren, Branch-Regeln erzwingen grüne Checks vor dem Merge. Agentische Entwicklung sollte sich in diesen Ablauf einfügen, statt an ihm vorbei zu arbeiten. Das hat mehrere Vorteile:
- Die CI des Zielrepos ist eine zweite, unabhängige Prüfung. Sie läuft in einer anderen Umgebung, oft mit weiteren Tests, und weiß nichts vom Agenten.
- Bestehende Regeln (geschützte Branches, Pflicht-Reviews) gelten automatisch auch für Agenten-Code.
- Die Historie bleibt an einem Ort: Wer später fragt, warum eine Änderung kam, findet sie im PR mit Beschreibung und Diskussion.
Wichtig ist die Rückkopplung: Wenn die CI rot wird, nachdem der Agent fertig ist, muss diese Information zurück in eine Korrekturschleife. Sonst bleibt ein roter PR liegen, und jemand muss manuell nachbessern.
In der Fabrik
Pull Request und PR-/CI-Rückkopplung einrichten
- Git-Remote-URL am Projekt setzen (Projektseite, Formular für die Remote-URL).
- GitHub-Token hinterlegen unter
/integrations. Schlüssel werden dort AES-GCM-verschlüsselt gespeichert und gegen den Anbieter validiert. - Allowlist prüfen: Die Fabrik verwendet den Token nur für Hosts aus
SOFTWAREFABRIK_GIT_ALLOWED_HOSTS. So kann eine manipulierte Remote-URL den Token nicht abgreifen (Details in Kapitel 8). - Ab jetzt pusht ein erfolgreicher Build-Run seinen Branch und öffnet einen Pull Request; der Merge erfolgt über den PR. Ohne Remote und Token greift der lokale Merge.
- Optional: PR-/CI-Rückkopplung mit
git.pr-feedback.enabledeinschalten (Default aus). Dann wartet der Run im ZustandWAITING_FOR_PRauf grüne CI und Merge; rote CI startet eine Korrektur.
Im Spec-Modus (Kapitel 4) tragen Fabrik-Commit und PR-Body die Trailer Spec: SPEC-<nnn> und Implements: AC-…. Reviewer im PR sehen damit sofort, welche Akzeptanzkriterien die Änderung umsetzen soll.
WAITING_FOR_PR, ist der PR noch nicht gemerged oder die CI nicht grün.
6.9 Vom „gut“ zum „richtig“: Akzeptanzkriterien im Gate
Alle bisher genannten Prüfungen beantworten überwiegend die Frage, ob Code gut ist. Um zu prüfen, ob er das Richtige tut, braucht das Gate einen fachlichen Maßstab. Zwei Bausteine machen das möglich:
- Akzeptanzkriterien mit stabilen IDs, die im Auftrag mitgegeben werden. Ein Reviewer kann dann gezielt fragen: Wird AC-007-03 durch den Diff erfüllt?
- Tests, die diese IDs referenzieren (im Namen, als Annotation oder im Kommentar). Damit wird Abdeckung messbar: Für welche Kriterien gibt es mindestens einen Test, für welche nicht?
Umgekehrt lässt sich auch fragen: Welche Änderungen im Diff gehören zu keinem Kriterium? Solches ungedecktes Verhalten ist nicht automatisch falsch, aber ein Hinweis auf Scope-Creep oder auf ein vergessenes Kriterium.
In der Fabrik
Akzeptanzkriterien erreichen die Reviewer
- Seit v0.35: Startet ein Build-Run aus einem Backlog-Eintrag mit Spec-Bezug (Spec-Modus
LEICHToderSTRENG), übergibt die Fabrik allen Reviewern die Akzeptanzkriterien (ID und Text) der freigegebenen Spec-Fassung inReviewRequest.acceptanceCriteria. Vorher stand dort fest nichts. - Seit v0.36: Derselbe Run bekommt die gebundenen Kriterien auch im Objective-Kopf, für jeden Execution-Adapter gleich, und die gebundene Fassung wird als
RUN_SPEC_GEBUNDENattestiert. - Seit v0.38.0 (SPEC-003): Ein regelbasierter Reviewer
spec-conformance(KategorieREQUIREMENTS, ohne Agent-CLI) meldet bei Runs mit gebundener Spec-Fassung jedes gebundene Kriterium, das in keinem Test referenziert wird, weist auf Tests mit unbekannten AC-IDs hin und listet geänderte Produktivdateien ohne AC-Zuordnung als „ungedecktes Verhalten“. Im ModusSTRENGist er Pflicht-Reviewer, fehlende Abdeckung istCRITICAL, und das Gate läuft blockierend, auch wenn der globale Gate-Modusadvisoryoderoffist; im ModusLEICHTsind seine Befunde beratend.
Wie du Kriterien so formulierst, dass daraus gute Tests werden, und wie die Abdeckung im Detail funktioniert, behandelt Kapitel 4.
6.10 Zusammenfassung: die Prüfkette eines Build-Runs
Auftrag (Ziel, ggf. Akzeptanzkriterien)
   │
   ├─ Freigabe vor EXECUTION (Default ohne Policy: run.approval-vor-merge)
   ▼
EXECUTION auf Branch sdlc/run-<id8>
   ▼
VALIDATION: mvn verify ──rot──► Korrekturschleife (Build-Feedback, ≤ 2)
   ▼ grün
Quality Gate: 6 read-only Reviewer
   │   advisory: anzeigen   blocking: FAILED/ERROR ──► Korrekturschleife
   ▼
Freigabe vor Merge (Approval-Policy / pflichtFreigabePhasen=VALIDATION)
   ▼
Merge in Base   oder   Push + Pull Request
                          ▼ (git.pr-feedback.enabled)
                       WAITING_FOR_PR: rote CI ──► Korrekturschleife
                          ▼ grün + gemerged
COMPLETED- Prüfe Ergebnisse, nicht Absichten. Die Selbstauskunft eines Agenten ist keine Prüfung.
- Setze billige, deterministische Prüfungen zuerst und mache sie so streng wie möglich.
- Reviewer sind unabhängig und read-only; wer schreibt, gibt nicht frei.
- Fail closed: Eine ausgefallene Prüfung ist kein Erfolg.
- Wiederhole nur mit neuer Information und begrenze die Versuche.
- Platziere menschliche Freigaben dort, wo sie etwas entscheiden, vor allem vor der Übernahme.
Übung
Übung: Prüfkette für ein Projekt entwerfen
Nimm ein eigenes Projekt oder das Beispiel „Telefonbuch-API“ aus dem Tutorial.
- Build-Gate: Liste auf, was ein vollständiger Build in diesem Projekt prüfen sollte. Welche Prüfungen fehlen heute und würden Agentenfehler früh fangen (Architekturtests, Abdeckung, Linter)?
- Gate-Modus: Lege fest, mit welchem
run.quality-gate.modeund welcher Policy (strict/lenient) du startest und nach welchem Kriterium du aufblockingwechselst. - Freigaben: Entscheide, ob du die Default-Freigabe vor der Ausführung (
run.approval-vor-merge) behältst, ob du per Approval-Policy eine Freigabe vor dem Merge verlangst und ob durun.approval-segregationbrauchst. Begründe in zwei Sätzen. - Praxis mit dem Mock: Stelle den Adapter auf
mock, lege einen Build-Run an und verfolge in der Run-Detailseite die Phasen bisCOMPLETED; den Halt inWAITING_FOR_APPROVALvor der Ausführung löst du mit „Freigeben und fortsetzen“. Öffne danach/runs/{id}/quality-gateund den Warum-Trace/runs/{id}/traceund notiere, welche Information du wo findest. - Review-Checkliste: Schreibe eine Checkliste mit fünf Punkten, die du bei jedem Agenten-Diff vor der Freigabe abhakst.
Lösungsskizze
Ein sinnvoller Start: Build mit Tests, ArchUnit und Abdeckungsschwelle; Gate auf advisory mit strict, nach etwa zehn Läufen ohne unbegründete Befunde auf blocking. Die Default-Freigabe vor der Ausführung bleibt an; im Team zusätzlich eine Approval-Policy mit Freigabe vor dem Merge, bei regulierten Projekten Segregation of Duties. Checkliste: Diff passt zum Ziel; Teständerungen begründet; keine Änderungen an Build-Dateien, Migrationen oder Konfiguration ohne Auftrag; offengelegte Annahmen des Agenten gelesen; Gate-Befunde mit HIGH/CRITICAL geklärt.
Kapitelfragen
-
Warum reicht es nicht, wenn ein Agent in seinem Abschlussbericht schreibt, dass alle Tests grün sind?
Musterantwort
Der Bericht ist eine Selbstauskunft. Der Agent kann sich irren, Tests nicht ausgeführt, geändert oder gelöscht haben. Zählen darf nur ein Build- und Testlauf, den die Pipeline außerhalb der Agenten-Sitzung ausführt. Der
hallucination-reviewerder Fabrik sucht genau nach dem Muster „Tests laufen durch“ ohne Teständerung. -
Was unterscheidet einen guten Test als Orakel von einem schlechten? Nenne drei Merkmale.
Musterantwort
Er prüft Verhalten statt Implementierung, er kann tatsächlich scheitern (wäre bei falschem Code rot), er deckt Negativ- und Grenzfälle ab und ist auf eine Anforderung rückführbar, idealerweise über eine AC-ID.
-
Erkläre den Unterschied zwischen Fail open und Fail closed am Beispiel eines Reviewers, dessen CLI fehlt.
Musterantwort
Fail open würde den fehlenden Reviewer überspringen und das Gate als bestanden werten. Fail closed wertet die ausgefallene Prüfung als nicht bestanden. Die Fabrik unterscheidet: Ein technisch gescheiterter Reviewer ergibt
ERROR, nie einen stillen Pass, und im Modusblockingstartet das die Korrekturschleife. Eine fehlende CLI ergibtSKIPPED; das ist ausdrücklich keinPASSED, und die Policystrictverlangt die Pflichtkategorien, sodass das Fehlen nicht still durchrutscht. -
Warum sind die Reviewer der Fabrik read-only, und wie wird das bei den LLM-Reviewern technisch durchgesetzt?
Musterantwort
Ein schreibender Reviewer wäre ein zweiter, ungeprüfter Autor und könnte den Prüfgegenstand während der Prüfung verändern. Befunde gehen deshalb als Rückmeldung an den Autor. Technisch läuft der Claude-Code-Review mit
--permission-mode dontAskund--disallowedToolsfür Edit, Write und Bash. -
Ein Build-Run ist zweimal in der Korrekturschleife gescheitert und steht in
NEEDS_CORRECTION. Was tust du, und was tust du nicht?Musterantwort
Nicht einfach neu starten in der Hoffnung auf Glück. Stattdessen den Run-Branch und die Fehlermeldungen ansehen, die Ursache einordnen (unklares Ziel, fehlender Kontext, widersprüchliche Anforderung, zu großer Auftrag) und gezielt handeln: Ziel schärfen, Kontext oder Memory ergänzen, Auftrag zerlegen und dann einen neuen Run starten. Der Base-Branch ist unberührt, es eilt also nicht.
-
Welche beiden Freigabepunkte kennt die Fabrik, und warum ist der zweite für regulierte Umgebungen entscheidend?
Musterantwort
Vor
EXECUTION(der Agent läuft erst nach Freigabe; ohne Approval-Policy der Default überrun.approval-vor-merge) und vor dem Merge inVALIDATION(über eine Approval-Policy bzw.pflichtFreigabePhasen). Ohne den zweiten Punkt wäre der Code bereits im Base-Branch, bevor jemand zugestimmt hat; die Zustimmung wäre dann Fassade. -
Dein Team will, dass Agenten-PRs auch die bestehende CI durchlaufen und bei roter CI automatisch nachgebessert wird. Was richtest du in der Fabrik ein?
Musterantwort
Git-Remote-URL am Projekt, GitHub-Token unter
/integrations, den Host in der Allowlist (SOFTWAREFABRIK_GIT_ALLOWED_HOSTS) undgit.pr-feedback.enabledeinschalten. Dann eröffnet ein erfolgreicher Build-Run einen PR, wartet inWAITING_FOR_PRauf grüne CI und Merge, und rote CI startet eine Korrektur. Das funktioniert heute nur mit GitHub. -
Wann ist
advisoryder bessere Gate-Modus alsblocking, und wann umgekehrt?Musterantwort
advisorypasst in der Einführungsphase oder bei Reviewern, deren Rauschen du noch nicht kennst: Befunde werden sichtbar, blockieren aber nicht.blockingpasst, sobald die Befunde verlässlich sind, und ist für regulierte Profile vorgegeben, damit einFAILEDoderERRORtatsächlich eine Korrektur erzwingt. -
Transfer: Ein Gate prüft, ob Code gut ist. Was fehlt, um zu prüfen, ob er das Richtige tut, und wie schließt die Fabrik diese Lücke?
Musterantwort
Ein fachlicher Maßstab: Akzeptanzkriterien mit IDs und Tests, die diese IDs referenzieren. Die Fabrik übergibt seit v0.35 die Kriterien der freigegebenen Spec an alle Reviewer und seit v0.36 im Objective-Kopf an den Agenten. Seit v0.38.0 prüft der Reviewer
spec-conformanceregelbasiert, ob jedes gebundene Kriterium durch mindestens einen Test belegt ist und welche Änderungen keinem Kriterium zugeordnet sind.